Convertisseur d'entités HTML
Encodez ou décodez facilement les entités HTML avec notre outil de conversion d'entités HTML pour une gestion précise du contenu web.
Le Convertisseur d'entités HTML est un outil gratuit qui convertit les références de caractères HTML en caractères décodés, et inversement, pour les utiliser dans des pages web, des systèmes de gestion de contenu et d'autres formats textuels.
Que sont les entités HTML et à quoi servent-elles ?
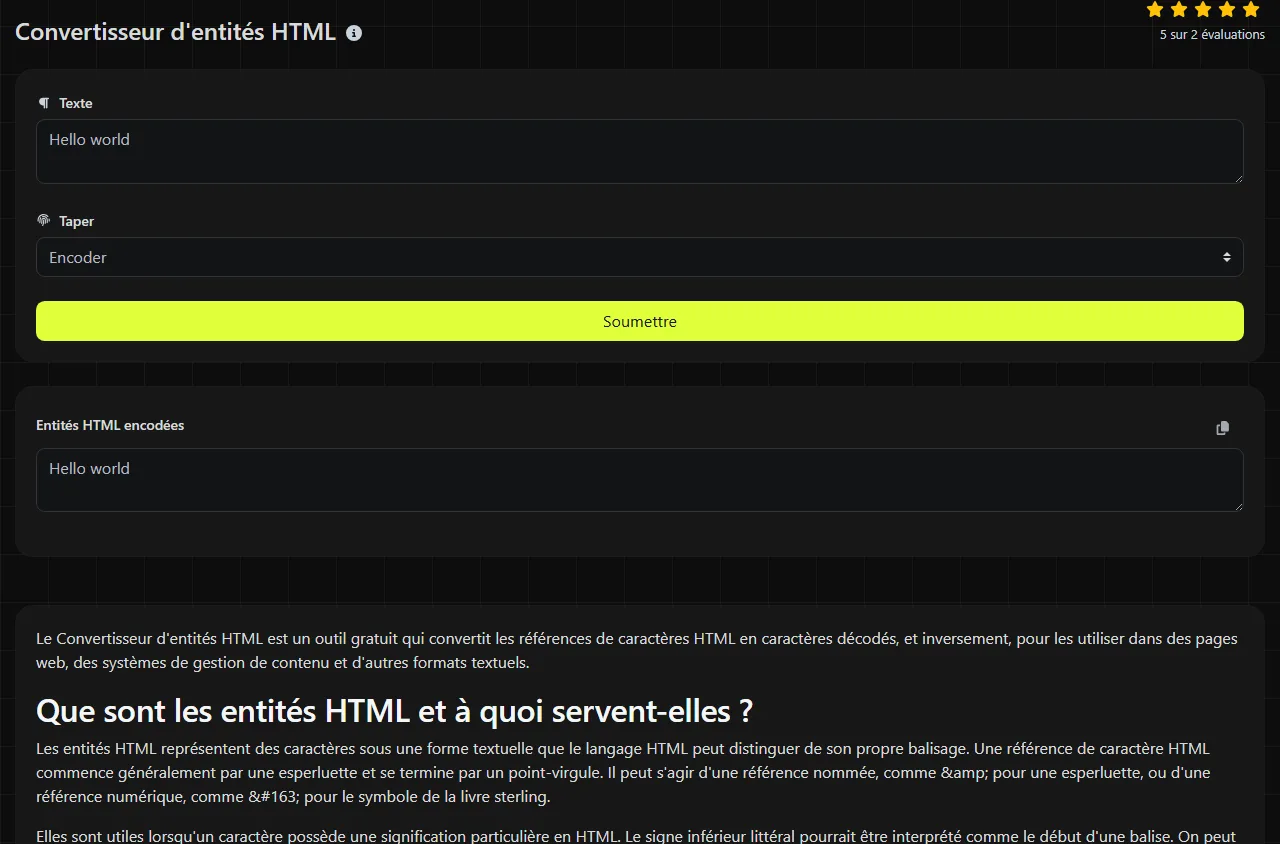
Les entités HTML représentent des caractères sous une forme textuelle que le langage HTML peut distinguer de son propre balisage. Une référence de caractère HTML commence généralement par une esperluette et se termine par un point-virgule. Il peut s'agir d'une référence nommée, comme & pour une esperluette, ou d'une référence numérique, comme £ pour le symbole de la livre sterling.
Elles sont utiles lorsqu'un caractère possède une signification particulière en HTML. Le signe inférieur littéral pourrait être interprété comme le début d'une balise. On peut donc l'écrire sous la forme <. Les références de caractères permettent aussi de représenter certains caractères dans du HTML ou un langage de balisage compatible sans les confondre avec le balisage ou une syntaxe de contrôle.
L'encodage des entités n'est pas un chiffrement et n'assure aucune confidentialité. N'importe qui peut lire ou décoder une référence d'entité. Ne l'utilise jamais pour masquer des mots de passe, des données personnelles ou du contenu confidentiel.
Comment utiliser le convertisseur d'entités HTML ?
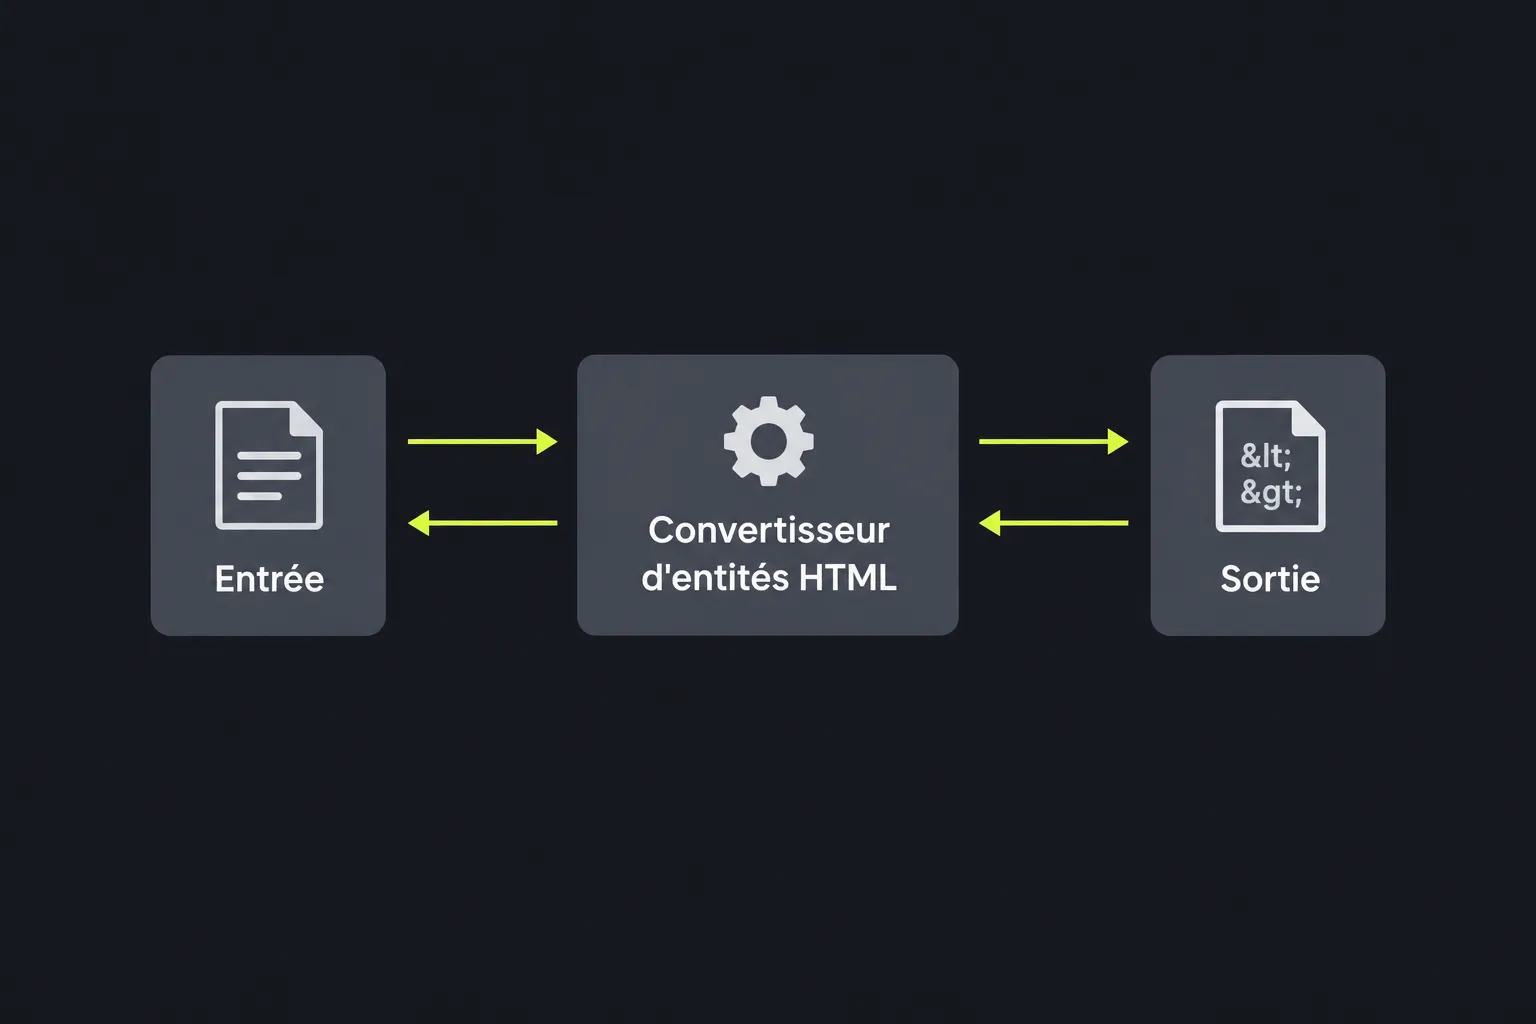
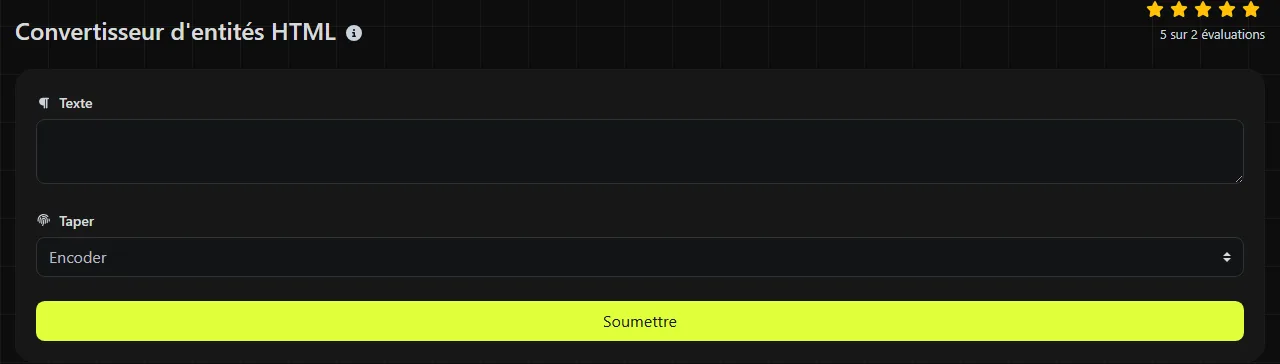
Saisis le texte concerné dans le champ Encoder ou Décoder, puis consulte le résultat correspondant dans Entités HTML encodées ou Entités HTML décodées. Utilise le résultat encodé lorsque le texte doit être inséré dans un contexte HTML approprié, qu'il s'agisse de texte ou d'un attribut. Choisis le résultat décodé lorsque tu as besoin des caractères représentés par des entités existantes.
La conversion est effectuée sur le serveur. Ta saisie lui est transmise via HTTPS et n'est pas stockée.
Avant de lancer la conversion, vérifie que tu as bien besoin d'entités HTML. Une valeur de chaîne de requête nécessite généralement un encodage URL avec des pourcentages, tandis qu'un nom de domaine internationalisé utilise Punycode. Le Décodeur d'URL et le Convertisseur IDN Punycode sont conçus pour ces formats respectifs.
À quoi ressemble un résultat encodé ou décodé ?
Le décodage remplace les références d'entités reconnues par les caractères qu'elles représentent. À l'inverse, la forme encodée représente les caractères à l'aide de la syntaxe des entités.
Entrée : <p>Tea & cake</p>
Résultat décodé : <p>Tea & cake</p>
Dans le résultat décodé, les chevrons sont des caractères qui pourraient devenir du balisage HTML si le contenu était inséré dans une page en tant que HTML. Le décodage n'assainit pas le contenu, ne supprime pas les scripts et ne sécurise pas du HTML non fiable. Traite le contenu décodé en fonction du contexte dans lequel il sera utilisé.
Exemples pratiques et saisies problématiques
Les entités nommées et les références numériques peuvent représenter le même caractère de différentes manières. Par exemple, & est la référence nommée d'une esperluette, tandis que & est sa référence numérique décimale et & sa forme hexadécimale.
- Les espaces ordinaires et les nombres écrits littéralement ne sont pas des références d'entités. Ils restent normalement du texte ordinaire.
- La ponctuation ne change que si elle apparaît sous la forme d'une référence d'entité reconnue ou si elle est délibérément encodée.
- Les lettres accentuées, les systèmes d'écriture non latins et les emoji peuvent être représentés par des références numériques, qui désignent des points de code Unicode indépendamment de l'encodage du fichier HTML source. Leur affichage correct dépend de la prise en charge par la police. L'encodage des caractères reste toutefois important si le résultat décodé est stocké ou transmis.
Lorsque tu crées des entités, ajoute le point-virgule final. Les navigateurs acceptent certaines références sans point-virgule dans des contextes limités, mais cette forme abrégée peut être ambiguë et se révèle moins compatible d'un analyseur à l'autre.
Où trouve-t-on des entités HTML en pratique ?
Les entités HTML apparaissent fréquemment dans le code source HTML, les systèmes de gestion de contenu, les éditeurs de texte enrichi et les e-mails HTML. Par exemple, la vue du code dans WordPress peut contenir pour une espace insécable, ou & lorsqu'une esperluette doit être préservée dans le balisage.
Elles peuvent également se trouver dans des données transportées par un autre format. Plusieurs couches d'encodage se superposent alors et doivent être traitées dans le bon ordre.
- Une charge utile JSON peut contenir un fragment HTML dont le texte inclut des entités. L'échappement JSON et le décodage des entités HTML sont deux opérations distinctes.
- Une chaîne de requête peut contenir du HTML encodé avec des pourcentages. Décode d'abord la couche URL, puis vérifie si le texte obtenu contient lui aussi des entités.
- Un URI de données peut contenir du HTML ou un autre texte comportant des entités, même si l'URI utilise lui-même un encodage avec des pourcentages ou en Base64.
- Un e-mail HTML peut encoder la ponctuation visible tout en utilisant un encodage de transfert MIME pour son acheminement.
- Un nom de domaine internationalisé peut apparaître à côté de contenu HTML encodé sous forme d'entités. Le domaine lui-même est toutefois généralement représenté en Punycode, et non avec des entités HTML.
Pourquoi le décodage des entités HTML échoue-t-il ou produit-il du texte illisible ?
Le décodage échoue généralement parce que la saisie est mal formée, utilise un autre type d'encodage ou contient plusieurs couches d'encodage. Recherche dans le texte d'origine des références de caractères HTML nommées ou numériques, au lieu d'enchaîner les conversions sans vérifier le résultat.
- Référence mal formée : l'absence d'une esperluette, d'un croisillon ou d'un point-virgule peut empêcher sa reconnaissance. Compare le texte avec des formes comme & ou &.
- Saisie doublement encodée : un texte comme &lt; peut être décodé une première fois en <, puis nécessiter un second passage volontaire pour devenir un signe inférieur.
- Jeu de caractères incorrect : un texte interprété avec le mauvais encodage peut afficher des caractères de remplacement ou des lettres accentuées corrompues.
- Mauvais format : un texte contenant des signes de pourcentage peut être encodé au format URL. Une longue chaîne composée de lettres, de chiffres, de signes plus, de barres obliques ou de signes égal à la fin peut être en Base64.
- Si la saisie est en Base64, variante ou alphabet incorrect : le Base64 compatible avec les URL emploie des caractères différents du Base64 standard. L'absence de remplissage peut aussi perturber certains décodeurs. Ces problèmes ne relèvent pas de la syntaxe des entités HTML et nécessitent un Décodeur Base64.
Questions fréquentes
Pourquoi ressemble-t-il à une espace normale ?
représente une espace insécable. Elle ressemble généralement à une espace normale, mais empêche un retour à la ligne à cet endroit. Les éditeurs peuvent la conserver de manière invisible. Pour diagnostiquer un problème d'espacement, utilise donc une vue du code source ou un inspecteur de caractères.
Les noms d'entités HTML sont-ils sensibles à la casse ?
Oui. Les références de caractères nommées ont une orthographe précise, et la casse peut déterminer si une référence est reconnue ou non. Utilise exactement le nom publié et ajoute son point-virgule, plutôt que de compter sur la correction d'erreurs du navigateur.
Faut-il utiliser une entité pour chaque lettre accentuée ?
Non. Un document HTML correctement déclaré en UTF-8 peut contenir directement des caractères tels que é, £ et 中文. Les entités restent utiles lorsque la syntaxe du balisage, un ancien système ou une règle de publication particulière les exige.
Peut-on utiliser les entités HTML en XML ?
Seul un petit nombre d'entités nommées sont prédéfinies en XML, notamment &, <, >, " et '. De nombreux noms valides en HTML ne le sont pas en XML, sauf si un type de document les définit. Les références numériques constituent donc souvent le choix le plus sûr.
Un convertisseur d'entités peut-il réparer du HTML incorrect ?
Non. Il peut convertir les références d'entités, mais il n'équilibre pas les balises, ne corrige pas leur imbrication et ne valide pas le document. Après la conversion, examine le balisage environnant et utilise un validateur HTML si la page continue de se comporter de façon inattendue.
Dernières vérifications
Vérifie si la source utilise des références de caractères HTML nommées ou numériques. Convertis uniquement la couche de références nécessaire, puis compare le résultat au texte qui doit être visible. Avant d'insérer du contenu décodé dans une page en ligne, examine les chevrons, les guillemets et les esperluettes obtenus dans leur contexte HTML réel.
Outils populaires
Créez votre propre signature personnalisée et téléchargez-la facilement avec notre outil de génération de signatures pour des signatures électroniques personnalisées.
Calculez la taille de n'importe quel texte en octets (B), kilooctets (KB) ou mégaoctets (MB) à l'aide de notre outil de calcul de taille de texte.
Utilisez l'outil de recherche inversée d'IP pour trouver rapidement et facilement le domaine ou l'hôte associé à une adresse IP.
Utilisez notre outil de ping pour vérifier rapidement et efficacement le statut et le temps de réponse de n'importe quel site web, serveur ou port.
L'outil de recherche d'IP de Digily Link fournit des informations détaillées sur toute adresse IP. Utilisez ce service en ligne gratuit pour obtenir des données IP complètes.
Générez instantanément votre lien WhatsApp gratuit avec notre générateur de liens WhatsApp. Ajoutez un message personnalisé et lancez des discussions en un clic, sans connexion ni code.