Конвертер HTML сутностей
Легко кодуйте або декодуйте HTML-ентітіз за допомогою нашого інструменту конвертації HTML-ентітіз для точного управління веб-контентом.
Конвертер HTML сутностей, це безплатний інструмент, який перетворює HTML-посилання на символи у звичайні символи й навпаки для використання на вебсторінках, у системах керування вмістом та інших текстових форматах.
Що таке HTML-сутності й навіщо вони потрібні?
HTML-сутності дають змогу записувати символи як текст, який HTML може відрізнити від власної розмітки. HTML-посилання на символ зазвичай починається з амперсанда й закінчується крапкою з комою. Воно може бути іменованим, наприклад & для амперсанда, або числовим, наприклад £ для знака фунта.
Такі посилання корисні, коли символ має особливе значення в HTML. Звичайний знак "менше" можна помилково сприйняти за початок тегу, тому його записують як <. Посилання на символи також дають системам змогу відтворювати певні символи в HTML або сумісній розмітці, не плутаючи їх із розміткою чи керівним синтаксисом.
Кодування сутностей не є шифруванням і не забезпечує конфіденційності. Будь-хто може прочитати або декодувати таке посилання, тому ніколи не використовуй його для приховування паролів, персональних даних чи конфіденційного вмісту.
Як користуватися конвертером HTML-сутностей?
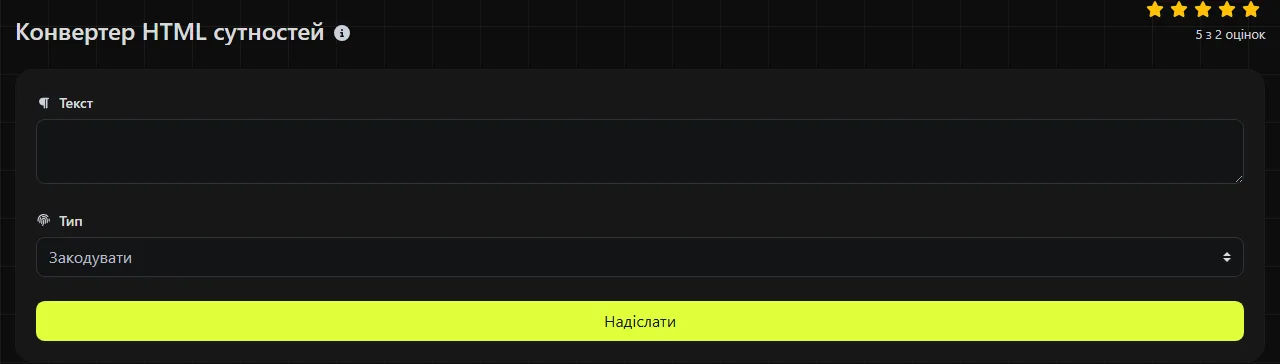
Введи потрібний текст у поле Закодувати або Декодувати, а потім переглянь відповідний результат Закодовано як HTML-сутності або Декодовано з HTML-сутностей. Використовуй закодований результат, коли текст потрібно вставити у відповідний текстовий контекст HTML або значення атрибута. Декодований результат потрібен, коли треба отримати символи, представлені наявними сутностями.
Перетворення виконується на сервері. Введені дані передаються на сервер через HTTPS і не зберігаються.
Перед перетворенням перевір, чи справді потрібні HTML-сутності. Значення рядка запиту зазвичай слід кодувати за допомогою відсоткового URL-кодування, а інтернаціоналізоване доменне ім'я використовує Punycode. Для цих форматів призначені відповідно Декодер URL і Конвертер IDN Punycode.
Який вигляд має закодований або декодований результат?
Під час декодування розпізнані посилання на символи замінюються відповідними символами. Під час кодування символи, навпаки, записуються за допомогою синтаксису сутностей.
Вхідні дані: <p>Tea & cake</p>
Декодований результат: <p>Tea & cake</p>
Кутові дужки в декодованому результаті є символами, які можуть стати HTML-розміткою, якщо вставити їх на сторінку як HTML. Декодування не очищує вміст, не видаляє скрипти й не робить ненадійний HTML безпечним. Обробляй декодовані дані відповідно до контексту, у якому їх буде використано.
Приклади та складні вхідні дані
Іменовані сутності й числові посилання можуть представляти той самий символ у різний спосіб. Наприклад, & є іменованим посиланням на амперсанд, & є його десятковим числовим посиланням, а & є шістнадцятковою формою.
- Звичайні пробіли та числа, записані безпосередньо, не є посиланнями на символи й зазвичай залишаються звичайним текстом.
- Розділові знаки змінюються лише тоді, коли їх записано як розпізнані посилання на символи або навмисно закодовано.
- Літери з діакритичними знаками, нелатинські системи письма та емодзі можна представляти числовими посиланнями на символи. Вони визначають кодові точки Unicode незалежно від кодування вихідного HTML. Правильне відображення залежить від підтримки шрифтом, а кодування символів має значення, якщо декодований результат зберігається або передається.
Під час створення сутностей додавай кінцеву крапку з комою. У деяких обмежених контекстах браузери допускають посилання без неї, але такий скорочений запис може бути неоднозначним і гірше переноситься між різними парсерами.
Де HTML-сутності трапляються на практиці?
HTML-сутності часто трапляються у вихідному коді HTML, системах керування вмістом, редакторах форматованого тексту та HTML-листах. Наприклад, у режимі перегляду коду WordPress можна побачити для нерозривного пробілу або &, коли амперсанд потрібно зберегти в розмітці.
Вони також можуть міститися всередині даних, переданих в іншому форматі. Так виникає кілька рівнів кодування, які потрібно обробляти в правильному порядку.
- Дані JSON можуть містити фрагмент HTML, у тексті якого є сутності. Екранування JSON і декодування HTML-сутностей є окремими операціями.
- Рядок запиту може містити HTML із відсотковим кодуванням. Спочатку декодуй рівень URL, а потім перевір, чи є в отриманому тексті сутності.
- URI даних може містити HTML або інший текст із сутностями, хоча сам URI може використовувати відсоткове кодування або Base64.
- HTML-лист може містити закодовані видимі розділові знаки й водночас використовувати транспортне кодування MIME для передавання.
- Інтернаціоналізоване доменне ім'я може стояти поруч із HTML, закодованим сутностями, але саме доменне ім'я зазвичай записується за допомогою Punycode, а не HTML-сутностей.
Чому HTML-сутності не декодуються або перетворюються на незрозумілі символи?
Зазвичай декодування не працює через неправильний формат вхідних даних, іншу схему кодування або наявність кількох рівнів кодування. Перевір вихідний текст на іменовані чи числові HTML-посилання на символи, а не повторюй перетворення без перевірки результату.
- Неправильно сформоване посилання: якщо немає амперсанда, знака номера або крапки з комою, посилання може не розпізнатися. Порівняй текст із такими формами, як & або &.
- Подвійно закодовані дані: текст на зразок &lt; після одного декодування може перетворитися на <. Щоб отримати знак "менше", його потрібно свідомо декодувати ще раз.
- Невідповідність набору символів: якщо текст інтерпретується в неправильному кодуванні, у ньому можуть з'явитися символи заміни або пошкоджені літери з діакритичними знаками.
- Неправильно визначений формат: текст зі знаками відсотка може бути закодований як URL. Довга послідовність літер, цифр, знаків плюса, скісних рисок або знаків рівності в кінці може бути Base64.
- Якщо вхідні дані мають формат Base64, вибрано неправильний варіант або алфавіт: безпечний для URL варіант Base64 використовує інші символи, ніж стандартний Base64. Відсутнє доповнення також може спричинити помилку в деяких декодерах. Ці проблеми не стосуються синтаксису HTML-сутностей, для них потрібен Декодер Base64.
Поширені запитання
Чому виглядає як звичайний пробіл?
Це нерозривний пробіл. Зазвичай він виглядає як звичайний, але не дозволяє перенести рядок у цьому місці. Редактори можуть непомітно зберігати такий символ, тому під час пошуку проблем із відступами переглянь вихідний код або перевір, який саме символ стоїть у цьому місці.
Чи залежить регістр у назвах HTML-сутностей?
Так. Іменовані посилання на символи мають визначене написання, а регістр може впливати на те, чи буде посилання розпізнано. Використовуй точну офіційну назву й додавай крапку з комою, не покладаючись на автоматичне виправлення помилок браузером.
Чи потрібно використовувати сутності для кожної літери з діакритичним знаком?
Ні. HTML-документ із правильно вказаним кодуванням UTF-8 може безпосередньо містити такі символи, як é, £ і 中文. Сутності залишаються корисними, якщо цього вимагає синтаксис розмітки, застаріла система або конкретне правило публікації.
Чи можна використовувати HTML-сутності в XML?
У XML попередньо визначено лише невеликий набір іменованих сутностей, зокрема &, <, >, " і '. Багато назв, допустимих у HTML, є недійсними в XML, якщо їх не визначено типом документа. Тому числові посилання на символи часто є безпечнішим варіантом.
Чи може конвертер сутностей виправити пошкоджений HTML?
Ні. Він може перетворювати посилання на символи, але не закриває незбалансовані теги, не виправляє їх вкладеність і не перевіряє документ. Після перетворення переглянь навколишню розмітку. Якщо сторінка й далі працює неочікувано, скористайся валідатором HTML.
Остаточна перевірка
Переконайся, що джерело використовує іменовані або числові HTML-посилання на символи, перетвори лише потрібний рівень таких посилань і порівняй результат із текстом, який має відображатися. Перш ніж додавати декодований вміст на робочу сторінку, перевір усі отримані кутові дужки, лапки й амперсанди в їхньому фактичному HTML-контексті.
Популярні інструменти
Створіть свій власний підпис і легко завантажте його за допомогою нашого інструменту генератора підписів для персоналізованих електронних підписів.
Розрахуйте розмір будь-якого тексту в байтах (B), кілобайтах (KB) або мегабайтах (MB) за допомогою нашого інструменту для обчислення розміру тексту.
Використовуйте інструмент зворотного пошуку IP, щоб швидко та легко знайти домен або хост, пов'язаний з будь-якою IP-адресою.
Використовуйте наш інструмент ping, щоб швидко та ефективно перевірити статус і час відгуку будь-якого вебсайту, сервера або порту.
Інструмент перевірки IP-адреси від Digily Link надає детальну інформацію про будь-яку IP-адресу. Скористайтеся цим безкоштовним онлайн-сервісом, щоб отримати всебічні дані про IP.
Створіть своє безкоштовне посилання на WhatsApp миттєво за допомогою нашого генератора посилань WhatsApp. Додайте власне повідомлення та починайте чати в один клік. Без входу в систему або кодування.