HTML-Entitäten-Konverter
Einfaches Kodieren oder Dekodieren von HTML-Entitäten mit unserem HTML-Entitäten-Konverter-Tool für eine präzise Verwaltung von Webinhalten.
Der HTML-Entitäten-Konverter ist ein kostenloses Tool, das HTML-Zeichenreferenzen in dekodierte Zeichen umwandelt und umgekehrt. Die Ergebnisse lassen sich in Webseiten, Content-Systemen und anderen textbasierten Formaten verwenden.
Was sind HTML-Entitäten und wozu gibt es sie?
HTML-Entitäten stellen Zeichen als Text dar, den HTML von seinem eigenen Markup unterscheiden kann. Eine HTML-Zeichenreferenz beginnt normalerweise mit einem kaufmännischen Und und endet mit einem Semikolon. Dabei kann es sich um eine benannte Zeichenreferenz handeln, etwa & für ein kaufmännisches Und, oder um eine numerische Zeichenreferenz wie £ für das Pfundzeichen.
Solche Referenzen sind nützlich, wenn ein Zeichen in HTML eine besondere Bedeutung hat. Ein direkt eingegebenes Kleiner-als-Zeichen könnte als Anfang eines Tags interpretiert werden. Deshalb lässt es sich als < schreiben. Zeichenreferenzen ermöglichen außerdem, bestimmte Zeichen in HTML oder kompatiblem Markup darzustellen, ohne dass sie mit Markup oder Steuersyntax verwechselt werden.
Die Entitätskodierung ist keine Verschlüsselung und schützt keine Informationen. Jeder kann eine Entitätsreferenz lesen oder dekodieren. Verwende sie daher niemals, um Passwörter, personenbezogene Daten oder vertrauliche Inhalte zu verbergen.
Wie verwende ich den HTML-Entitäten-Konverter?
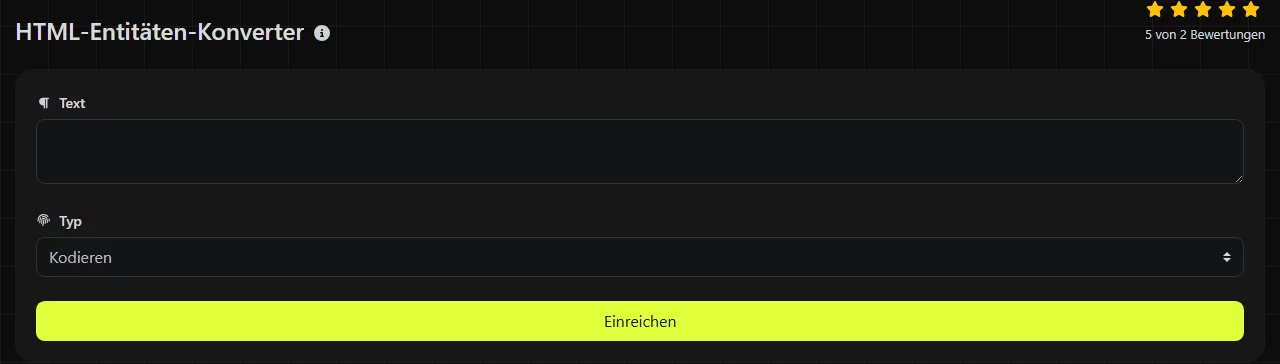
Gib den gewünschten Text in das Feld Kodieren oder Dekodieren ein und lies anschließend das entsprechende Ergebnis unter Als HTML-Entitäten kodiert oder HTML-Entitäten dekodiert ab. Verwende die kodierte Ausgabe, wenn Text in einem passenden HTML-Text- oder Attributkontext erscheinen soll. Die dekodierte Ausgabe eignet sich, wenn du die Zeichen benötigst, die durch vorhandene Entitäten dargestellt werden.
Die Konvertierung erfolgt auf dem Server. Deine Eingabe wird über HTTPS an den Server übertragen und nicht gespeichert.
Prüfe vor der Konvertierung, ob du tatsächlich HTML-Entitäten benötigst. Ein Wert in einer Abfragezeichenfolge muss normalerweise stattdessen per URL-Prozentkodierung kodiert werden, während internationalisierte Domains Punycode verwenden. Für diese Formate sind der URL-Decoder beziehungsweise der IDN Punycode-Konverter vorgesehen.
Wie sieht ein kodiertes oder dekodiertes Ergebnis aus?
Beim Dekodieren werden erkannte Entitätsreferenzen durch die jeweils dargestellten Zeichen ersetzt. In der kodierten Form werden Zeichen dagegen mithilfe der Entitätssyntax dargestellt.
Eingabe: <p>Tea & cake</p>
Dekodierte Ausgabe: <p>Tea & cake</p>
Die spitzen Klammern in der dekodierten Ausgabe sind Zeichen, die beim Einfügen in eine Seite als HTML zu Markup werden könnten. Durch das Dekodieren werden Inhalte weder bereinigt noch Skripte entfernt oder nicht vertrauenswürdiges HTML sicher gemacht. Behandle dekodiertes Material entsprechend dem Kontext, in dem du es verwenden möchtest.
Beispiele und problematische Eingaben
Benannte Entitäten und numerische Zeichenreferenzen können dasselbe Zeichen auf unterschiedliche Weise darstellen. So ist & eine benannte Referenz für ein kaufmännisches Und, während & die dezimale numerische Referenz und & die hexadezimale Form ist.
- Normale Leerzeichen und direkt eingegebene Zahlen sind keine Entitätsreferenzen und bleiben üblicherweise unveränderter Text.
- Satzzeichen ändern sich nur, wenn sie als erkannte Entitätsreferenz vorliegen oder gezielt kodiert werden.
- Buchstaben mit Akzent, nicht lateinische Schriften und Emojis lassen sich durch numerische Zeichenreferenzen darstellen. Diese geben Unicode-Codepunkte unabhängig von der Zeichenkodierung des HTML-Quelltexts an. Die korrekte Darstellung hängt von der Unterstützung durch die verwendete Schriftart ab. Die Zeichenkodierung spielt dagegen eine Rolle, wenn die dekodierte Ausgabe gespeichert oder übertragen wird.
Füge beim Erstellen von Entitäten das abschließende Semikolon hinzu. Browser akzeptieren in bestimmten Kontexten einige Referenzen ohne Semikolon. Diese Kurzform kann jedoch mehrdeutig sein und ist zwischen verschiedenen Parsern weniger portabel.
Wo kommen HTML-Entitäten in der Praxis vor?
HTML-Entitäten finden sich häufig im HTML-Quelltext, in Content-Management-Systemen, Rich-Text-Editoren und HTML-E-Mails. In der Codeansicht von WordPress kann beispielsweise für ein geschütztes Leerzeichen stehen oder & verwendet werden, damit ein kaufmännisches Und im Markup erhalten bleibt.
Sie können außerdem in Daten vorkommen, die innerhalb eines anderen Formats übertragen werden. Dadurch entstehen mehrere Kodierungsebenen, die in der richtigen Reihenfolge verarbeitet werden müssen.
- Eine JSON-Nutzlast kann ein HTML-Fragment enthalten, dessen Text Entitäten verwendet. JSON-Escaping und das Dekodieren von HTML-Entitäten sind zwei getrennte Vorgänge.
- Eine Abfragezeichenfolge kann prozentkodiertes HTML enthalten. Dekodiere zuerst die URL-Ebene und prüfe anschließend, ob der daraus entstandene Text ebenfalls Entitäten enthält.
- Ein Daten-URI kann HTML oder anderen Text mit Entitäten enthalten, obwohl der URI selbst möglicherweise Prozentkodierung oder Base64 verwendet.
- Eine HTML-E-Mail kann sichtbare Satzzeichen kodieren und gleichzeitig MIME-Transferkodierung für die Übertragung nutzen.
- Eine internationalisierte Domain kann neben HTML mit kodierten Entitäten vorkommen. Die Domain selbst wird jedoch normalerweise mit Punycode und nicht mit HTML-Entitäten dargestellt.
Warum schlägt die Dekodierung fehl oder erzeugt unleserlichen Text?
Die Dekodierung schlägt meist fehl, weil die Eingabe fehlerhaft ist, ein anderes Kodierungsverfahren verwendet oder mehrere Kodierungsebenen enthält. Suche im ursprünglichen Text nach benannten oder numerischen HTML-Zeichenreferenzen, statt Konvertierungen wiederholt auszuführen, ohne das jeweilige Ergebnis zu prüfen.
- Fehlerhafte Referenz: Fehlt das kaufmännische Und, das Nummernzeichen oder das Semikolon, wird die Referenz möglicherweise nicht erkannt. Vergleiche den Text mit Formen wie & oder &.
- Doppelt kodierte Eingabe: Text wie &lt; kann beim ersten Dekodieren zu < werden. Erst ein weiterer, bewusst ausgeführter Durchgang macht daraus ein Kleiner-als-Zeichen.
- Falscher Zeichensatz: Wird Text mit der falschen Zeichenkodierung interpretiert, können Ersatzzeichen oder beschädigte Buchstaben mit Akzent erscheinen.
- Falsches Format: Text mit Prozentzeichen ist möglicherweise URL-kodiert. Eine lange Zeichenfolge aus Buchstaben, Ziffern, Pluszeichen und Schrägstrichen oder mit Gleichheitszeichen am Ende könnte Base64 sein.
- Bei Base64 die falsche Variante oder das falsche Alphabet: URL-sicheres Base64 verwendet andere Zeichen als Standard-Base64. Auch fehlendes Padding kann bei manchen Decodern zu Fehlern führen. Diese Probleme gehören nicht zur Syntax von HTML-Entitäten und erfordern einen Base64-Decoder.
Häufig gestellte Fragen
Warum sieht wie ein normales Leerzeichen aus?
steht für ein geschütztes Leerzeichen. Dieses sieht normalerweise wie ein gewöhnliches Leerzeichen aus, verhindert an dieser Stelle aber einen Zeilenumbruch. Editoren können es unsichtbar beibehalten. Nutze deshalb die Quelltextansicht oder eine Zeichenprüfung, wenn du Probleme mit Abständen untersuchst.
Wird bei HTML-Entitäten zwischen Groß- und Kleinschreibung unterschieden?
Ja. Benannte Zeichenreferenzen haben eine festgelegte Schreibweise, und die Groß- oder Kleinschreibung kann darüber entscheiden, ob eine Referenz erkannt wird. Verwende den veröffentlichten Namen exakt und füge das Semikolon hinzu, statt dich auf die Fehlerkorrektur des Browsers zu verlassen.
Brauche ich für jeden Buchstaben mit Akzent eine Entität?
Nein. Ein korrekt als UTF-8 deklariertes HTML-Dokument kann Zeichen wie é, £ und 中文 direkt enthalten. Entitäten bleiben sinnvoll, wenn die Markup-Syntax, ein älteres System oder eine bestimmte Veröffentlichungsregel sie erfordert.
Kann ich HTML-Entitäten auch in XML verwenden?
Nur eine kleine Gruppe benannter Entitäten ist in XML vordefiniert, darunter &, <, >, " und '. Viele in HTML gültige Namen sind in XML ungültig, sofern sie nicht durch einen Dokumenttyp definiert werden. Numerische Zeichenreferenzen sind daher häufig die sicherere Wahl.
Kann ein Entitäten-Konverter fehlerhaftes HTML reparieren?
Nein. Er kann Entitätsreferenzen umwandeln, gleicht aber keine Tags aus, korrigiert keine Verschachtelung und validiert auch kein Dokument. Prüfe nach der Konvertierung das umgebende Markup und verwende einen HTML-Validator, wenn sich die Seite weiterhin unerwartet verhält.
Abschließende Prüfung
Stelle fest, ob die Quelle benannte oder numerische HTML-Zeichenreferenzen verwendet. Konvertiere nur die benötigte Zeichenreferenzebene und vergleiche das Ergebnis mit dem Text, der sichtbar sein soll. Bevor du dekodierte Inhalte in eine produktive Seite einfügst, prüfe alle daraus entstandenen spitzen Klammern, Anführungszeichen und kaufmännischen Und-Zeichen in ihrem tatsächlichen HTML-Kontext.
Beliebte Werkzeuge
Erstellen Sie Ihre eigene benutzerdefinierte Signatur und laden Sie sie einfach mit unserem Signaturgenerator-Tool für personalisierte E-Signaturen herunter.
Berechnen Sie die Größe eines beliebigen Textes in Bytes (B), Kilobytes (KB) oder Megabytes (MB) mit unserem Textgrößenrechner.
Verwenden Sie das Reverse-IP-Lookup-Tool, um die Domain oder den Host zu finden, der mit einer IP-Adresse verknüpft ist, schnell und einfach.
Verwenden Sie unser Ping-Tool, um den Status und die Antwortzeit einer beliebigen Website, eines Servers oder Ports schnell und effizient zu überprüfen.
Das IP-Lookup-Tool von Digily Link bietet detaillierte Informationen zu jeder IP-Adresse. Nutzen Sie diesen kostenlosen Online-Dienst, um umfassende IP-Daten zu erhalten.
Erstellen Sie mit unserem WhatsApp-Link-Generator sofort Ihren kostenlosen WhatsApp-Link. Fügen Sie eine benutzerdefinierte Nachricht hinzu und starten Sie Chats mit einem Klick, ganz ohne Anmeldung oder Programmierung.