Convertidor de entidades HTML
Codifica o decodifica entidades HTML para cualquier cadena de texto de manera rápida y eficiente.
El Convertidor de entidades HTML es una herramienta gratuita que convierte referencias de caracteres HTML en caracteres decodificados y viceversa, para usarlos en páginas web, sistemas de gestión de contenidos y otros formatos basados en texto.
¿Qué son las entidades HTML y para qué sirven?
Las entidades HTML representan caracteres mediante texto que HTML puede distinguir de su propio marcado. Una referencia de carácter HTML suele comenzar con un ampersand y terminar con un punto y coma. Puede ser una referencia con nombre, como & para representar un ampersand, o una referencia numérica, como £ para el símbolo de la libra.
Resultan útiles cuando un carácter tiene un significado especial en HTML. Un signo menor que escrito directamente podría confundirse con el inicio de una etiqueta, por lo que puede representarse como <. Las referencias de caracteres también permiten representar determinados caracteres en HTML o en lenguajes de marcado compatibles sin confundirlos con el marcado o la sintaxis de control.
La codificación de entidades no es un método de cifrado ni ofrece confidencialidad. Cualquiera puede leer o decodificar una referencia de entidad, así que nunca debes utilizarla para ocultar contraseñas, datos personales o contenido confidencial.
¿Cómo se usa el convertidor de entidades HTML?
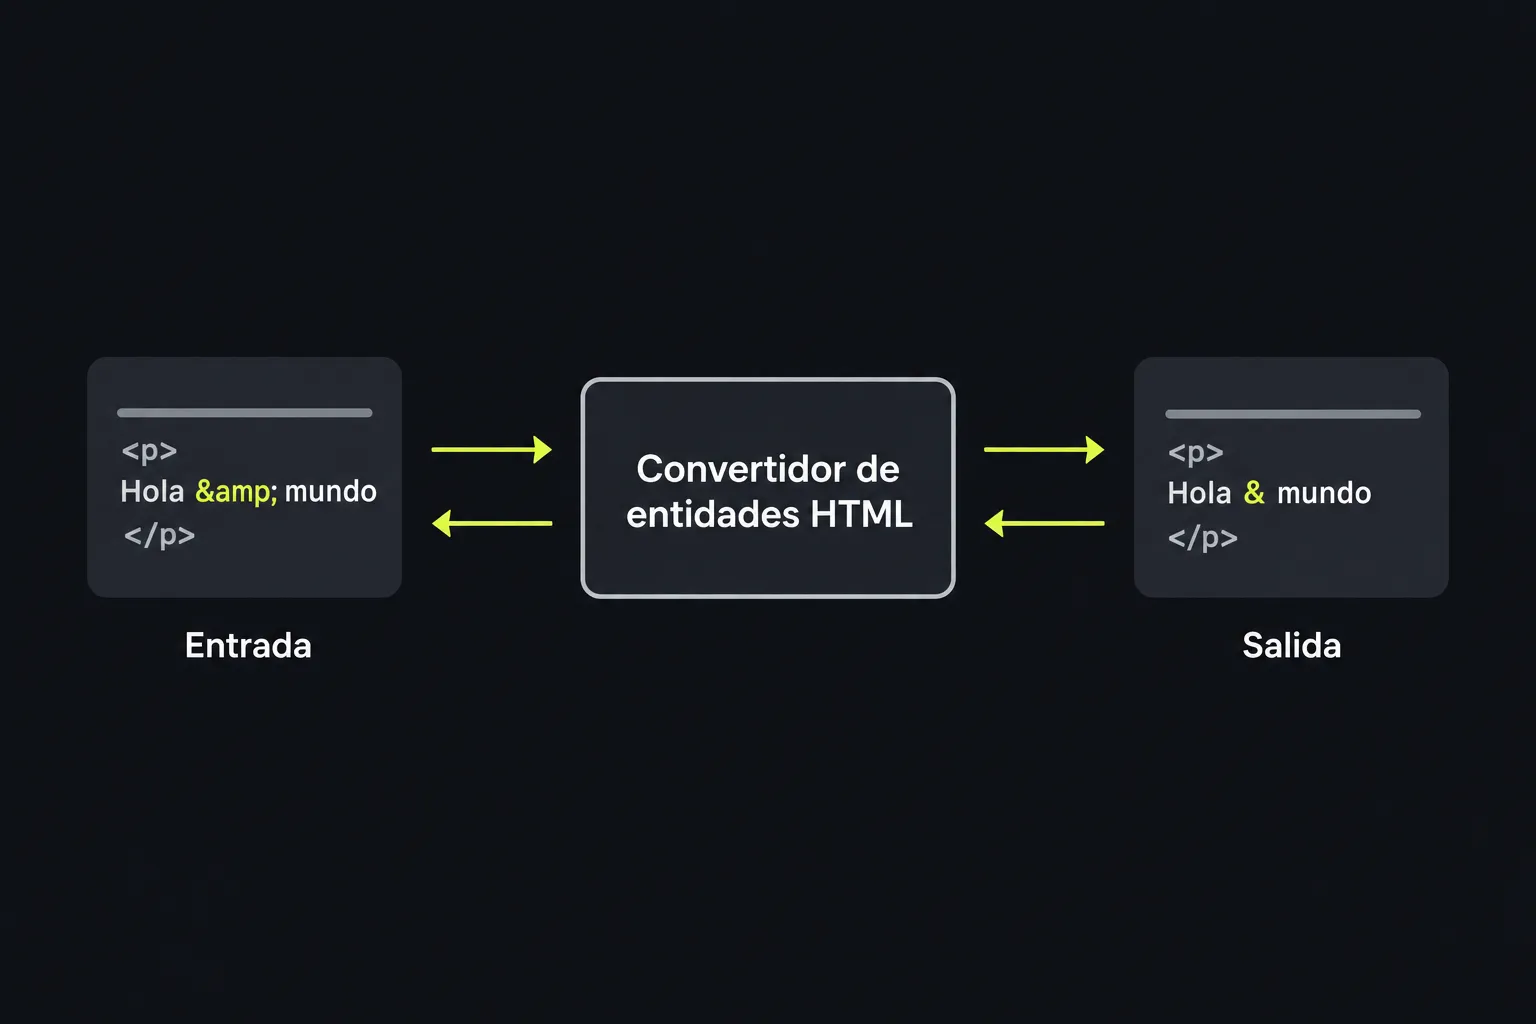
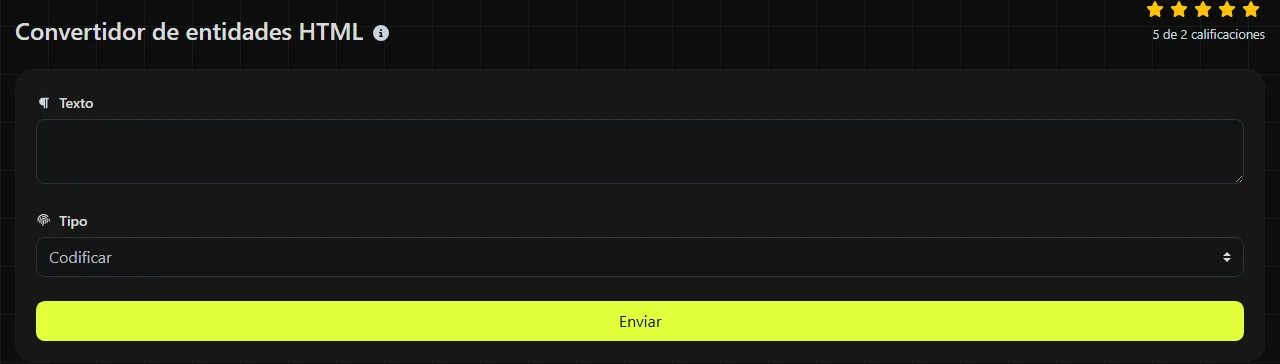
Introduce el texto correspondiente en el campo Codificar o Decodificar y consulta el resultado en Entidades HTML codificadas o Entidades HTML decodificadas. Utiliza la salida codificada cuando el texto deba aparecer en un contexto de texto o de atributo HTML adecuado. Usa la salida decodificada cuando necesites obtener los caracteres representados por entidades existentes.
La conversión se ejecuta en el servidor. El contenido que introduces se envía al servidor mediante HTTPS y no se almacena.
Antes de convertir el texto, comprueba si realmente necesitas entidades HTML. Los valores de una cadena de consulta suelen requerir codificación porcentual de URL, mientras que los dominios internacionalizados utilizan Punycode. Las herramientas Decodificación de URL y Conversión de IDN a Punycode están pensadas para esos formatos, respectivamente.
¿Qué aspecto tiene un resultado codificado o decodificado?
Un resultado decodificado sustituye las referencias de entidades reconocidas por los caracteres que representan. Una forma codificada, en cambio, representa los caracteres mediante la sintaxis de entidades.
Entrada: <p>Tea & cake</p>
Salida decodificada: <p>Tea & cake</p>
Los signos menor que y mayor que de la salida decodificada son caracteres que podrían convertirse en marcado HTML si se insertaran como HTML en una página. Decodificar contenido no lo sanea, no elimina scripts ni hace seguro el HTML que no sea de confianza. Trata el material decodificado según el contexto en el que vayas a utilizarlo.
Ejemplos prácticos y entradas problemáticas
Las entidades con nombre y las referencias numéricas pueden representar el mismo carácter de distintas formas. Por ejemplo, & es una referencia con nombre para un ampersand, mientras que & es su referencia numérica decimal y & es la forma hexadecimal.
- Los espacios normales y los números escritos directamente no son referencias de entidades y, por lo general, permanecen como texto corriente.
- Los signos de puntuación solo cambian cuando aparecen como una referencia de entidad reconocida o se codifican de forma intencionada.
- Las letras acentuadas, las escrituras no latinas y los emojis pueden representarse mediante referencias numéricas de caracteres, que identifican puntos de código Unicode independientemente de la codificación del código fuente HTML. Su correcta visualización depende de que la fuente los admita, mientras que la codificación de caracteres es importante si la salida decodificada se almacena o se transmite.
Incluye el punto y coma final al preparar las entidades. Los navegadores admiten algunas referencias sin punto y coma en contextos limitados, pero esa forma abreviada puede resultar ambigua y es menos compatible entre distintos analizadores.
¿Dónde se utilizan las entidades HTML?
Las entidades HTML aparecen habitualmente en el código fuente HTML, los sistemas de gestión de contenidos, los editores de texto enriquecido y los correos electrónicos en HTML. Por ejemplo, la vista de código de WordPress puede contener para representar un espacio de no separación o & cuando es necesario conservar un ampersand en el marcado.
También pueden aparecer dentro de datos transportados mediante otro formato. Esto crea varias capas de codificación que deben procesarse en el orden correcto.
- Una carga útil JSON puede contener un fragmento HTML cuyo texto incluya entidades. El escape de JSON y la decodificación de entidades HTML son operaciones independientes.
- Una cadena de consulta puede contener HTML con codificación porcentual. Decodifica primero la capa de URL y después comprueba si el texto resultante también contiene entidades.
- Un URI de datos puede incluir HTML u otro texto con entidades, aunque el propio URI podría utilizar codificación porcentual o Base64.
- Un correo electrónico HTML puede codificar signos de puntuación visibles y utilizar al mismo tiempo una codificación de transferencia MIME para su transporte.
- Un dominio internacionalizado puede aparecer junto a HTML codificado con entidades, pero el propio dominio suele representarse mediante Punycode, no mediante entidades HTML.
¿Por qué falla la decodificación de entidades HTML o aparecen caracteres extraños?
La decodificación suele fallar porque la entrada está mal formada, utiliza otro sistema de codificación o contiene más de una capa de codificación. Examina el texto original para localizar referencias de caracteres HTML con nombre o numéricas, en lugar de aplicar conversiones repetidamente sin revisar el resultado.
- Referencia mal formada: Si falta el ampersand, el signo de almohadilla o el punto y coma, es posible que la referencia no se reconozca. Compara el texto con formas como & o &.
- Entrada codificada dos veces: Un texto como &lt; puede decodificarse una vez como < y necesitar otra conversión intencionada para convertirse en un signo menor que.
- Codificación de caracteres incorrecta: Si el texto se interpreta con una codificación de caracteres equivocada, pueden aparecer símbolos de sustitución o caracteres acentuados dañados.
- Formato equivocado: Un texto que contiene signos de porcentaje podría estar codificado como URL. Una cadena larga formada por letras, números, signos más, barras o signos igual al final podría ser Base64.
- Si la entrada es Base64, variante o alfabeto incorrectos: Base64 seguro para URL utiliza caracteres diferentes de los de Base64 estándar. La ausencia de relleno también puede provocar errores en algunos decodificadores. Estos problemas no forman parte de la sintaxis de entidades HTML y requieren la herramienta Decodificación Base64.
Preguntas frecuentes
¿Por qué parece un espacio normal?
Representa un espacio de no separación. Suele tener el mismo aspecto que un espacio normal, pero impide que se produzca un salto de línea en esa posición. Los editores pueden conservarlo de forma invisible, así que utiliza una vista del código fuente o inspecciona los caracteres uno a uno para diagnosticar problemas de espaciado.
¿Las entidades HTML distinguen entre mayúsculas y minúsculas?
Sí. Las referencias de caracteres con nombre tienen una grafía definida, y el uso de mayúsculas o minúsculas puede determinar si se reconoce una referencia. Utiliza el nombre publicado exacto e incluye el punto y coma, en lugar de depender de la corrección de errores del navegador.
¿Tengo que usar entidades para todas las letras acentuadas?
No. Un documento HTML con UTF-8 declarado correctamente puede contener directamente caracteres como é, £ y 中文. Las entidades siguen siendo útiles cuando las exige la sintaxis del marcado, un sistema antiguo o una regla de publicación específica.
¿Se pueden usar entidades HTML en XML?
XML solo incluye de forma predefinida un conjunto reducido de entidades con nombre, entre ellas &, <, >, " y '. Muchos nombres válidos en HTML no lo son en XML, salvo que los defina un tipo de documento. Por eso, las referencias numéricas de caracteres suelen ser la opción más segura.
¿Puede un convertidor de entidades reparar HTML dañado?
No. Puede convertir referencias de entidades, pero no equilibra etiquetas, corrige su anidamiento ni valida documentos. Después de la conversión, revisa el marcado circundante y utiliza un validador HTML si la página sigue comportándose de forma inesperada.
Comprobaciones finales
Confirma si el contenido de origen utiliza referencias de caracteres HTML con nombre o numéricas, convierte únicamente la capa de referencias necesaria y compara el resultado con el texto que debería verse. Antes de insertar contenido decodificado en una página publicada, revisa los signos menor que y mayor que, las comillas y los ampersands resultantes dentro de su contexto HTML real.
Herramientas populares
Crea y descarga tu propia firma personalizada de manera rápida y sencilla con nuestro generador de firmas.
Calcula el tamaño de cualquier texto en Bytes, Kilobytes o Megabytes de manera precisa y rápida.
Realiza búsquedas inversas de IP para encontrar dominios o anfitriones asociados a cualquier dirección IP.
Realiza pruebas de ping para verificar la conectividad y tiempo de respuesta de sitios web, servidores o puertos.
La herramienta de consulta de IP de Digily Link ofrece información detallada sobre cualquier dirección IP. Utiliza este servicio online gratuito para obtener datos completos de la IP.
Genera al instante tu enlace gratuito de WhatsApp con nuestro generador de enlaces de WhatsApp. Añade un mensaje personalizado e inicia chats con un clic, sin iniciar sesión ni programar.