HTML实体编码解码
使用我们的HTML实体编码解码工具对任何给定的输入进行编码或解码,确保网页内容的正确显示。
HTML实体编码解码是一款免费工具,可在 HTML 字符引用与解码后的字符之间进行转换,适用于网页、内容管理系统及其他基于文本的格式。
什么是 HTML 实体,为什么需要它?
HTML 实体使用一段 HTML 能与自身标记区分的文本来表示字符。HTML 字符引用通常以 & 符号开头,以分号结尾。它可以是命名字符引用,例如用 & 表示 & 符号,也可以是数字字符引用,例如用 £ 表示英镑符号。
当某个字符在 HTML 中具有特殊含义时,实体就很有用。例如,直接写出的小于号可能被当作标签的开头,因此可以写成 <。字符引用还可以让系统在 HTML 或兼容的标记语言中表示特定字符,而不会将其与标记或控制语法混淆。
实体编码不是加密,无法提供任何保密性。任何人都能读取或解码实体引用,因此绝不能用它隐藏密码、个人数据或机密内容。
如何使用 HTML 实体编码解码?
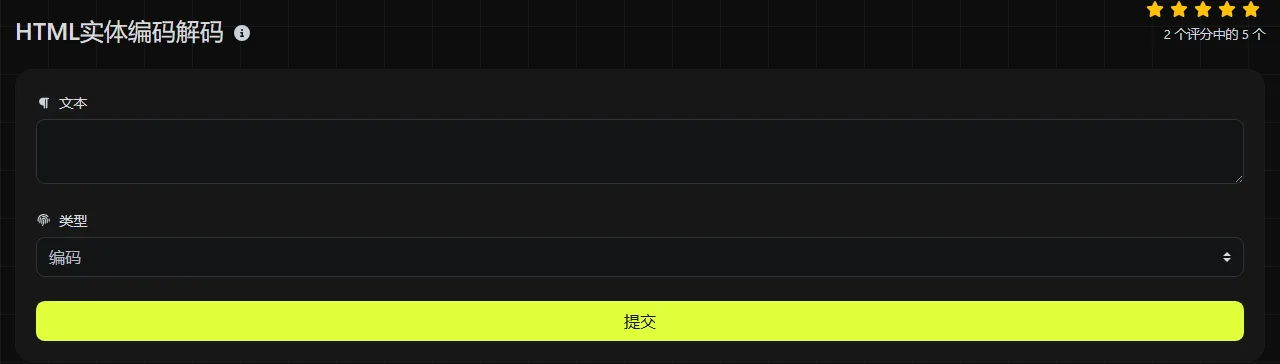
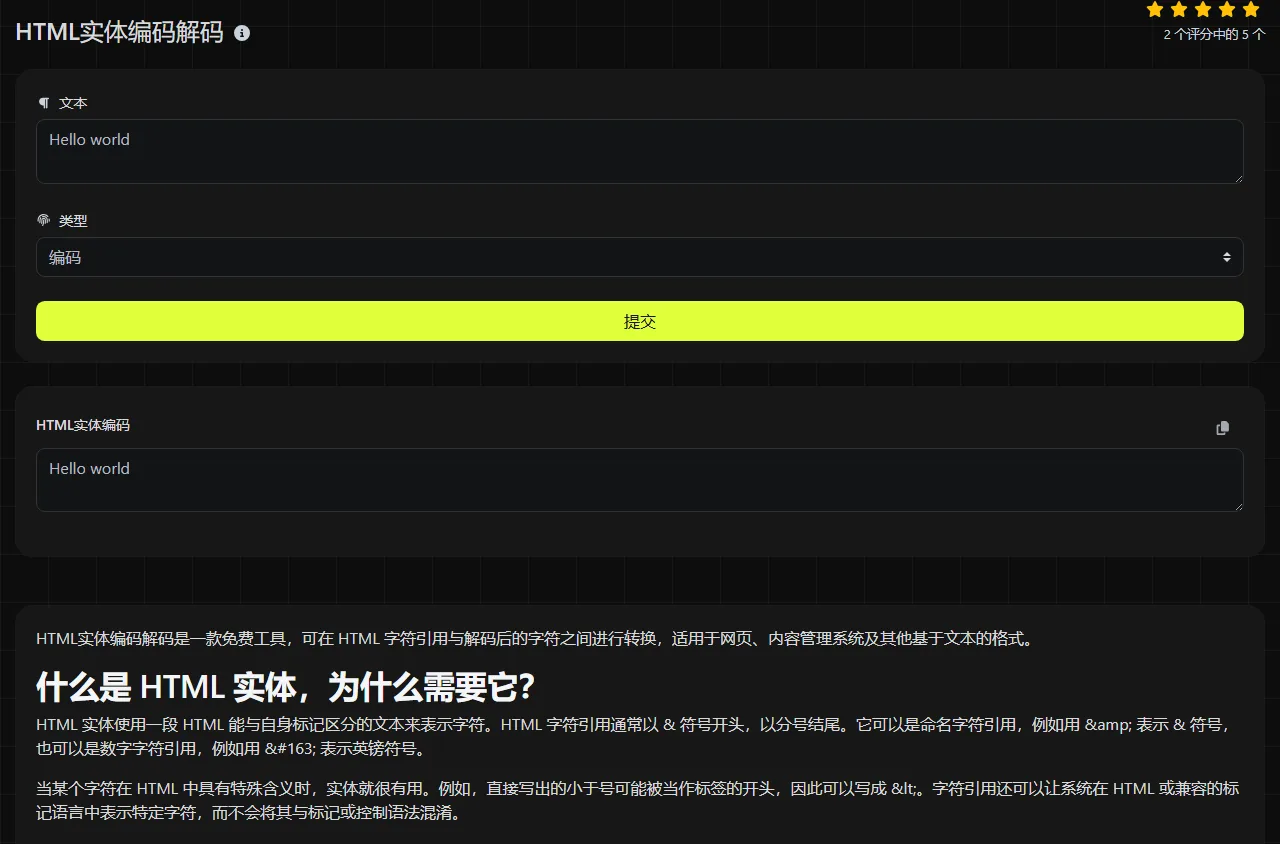
在标有编码或解码的字段中输入相关文本,然后查看对应的 HTML 实体编码结果或 HTML实体解码。如果文本需要放入适用的 HTML 文本或属性上下文,请使用编码结果。如果需要获取现有实体所表示的字符,请使用解码结果。
转换在服务器上运行。输入内容会通过 HTTPS 发送到服务器,但不会被存储。
转换前,先确认是否需要 HTML 实体。查询字符串中的值通常应进行 URL 百分号编码,而国际化域名使用 Punycode。对于这两种格式,请分别使用 URL解码工具和 IDN到Punycode转换。
编码或解码结果是什么样的?
解码结果会将可识别的实体引用替换为其表示的字符,而编码结果则使用实体语法来表示字符。
输入:<p>Tea & cake</p>
解码输出:<p>Tea & cake</p>
解码结果中的尖括号是字符,但如果将结果作为 HTML 插入网页,它们可能会成为 HTML 标记。解码不会清理内容、移除脚本,也不会让不受信任的 HTML 变得安全。请根据解码内容的实际使用环境进行处理。
实际示例与特殊输入
命名实体和数字字符引用可以用不同方式表示同一个字符。例如,& 是 & 符号的命名引用,& 是其十进制数字引用,& 则是十六进制形式。
- 普通空格和直接写出的数字不是实体引用,通常会保留为普通文本。
- 只有当标点符号以可识别的实体引用形式出现,或被明确编码时,它才会发生变化。
- 带重音符号的字母、非拉丁文字和 emoji 都可以使用数字字符引用表示。这类引用直接标识 Unicode 码点,不受 HTML 源文件编码影响。字符能否正确显示取决于字体支持,而当解码结果需要存储或传输时,字符编码也很重要。
编写实体时,请包含末尾的分号。浏览器在少数上下文中能够容忍省略分号的引用,但这种简写可能产生歧义,而且在不同解析器之间的兼容性较差。
HTML 实体通常出现在哪里?
HTML 实体常见于 HTML 源代码、内容管理系统、富文本编辑器和 HTML 邮件。例如,WordPress 的代码视图中可能会用 表示不换行空格,或在需要保留 & 符号的标记中使用 &。
实体也可能出现在另一种格式所承载的数据中。这会形成多层编码,必须按正确顺序逐层处理。
- JSON 载荷可能包含 HTML 片段,而其中的文本又包含实体。JSON 转义与 HTML 实体解码是两项独立操作。
- 查询字符串可能包含经过百分号编码的 HTML。先解码 URL 层,再判断得到的文本是否还包含实体。
- 数据 URI 可以包含带实体的 HTML 或其他文本,不过 URI 本身也可能使用百分号编码或 Base64。
- HTML 邮件可能会对可见的标点符号进行实体编码,同时使用 MIME 传输编码来发送内容。
- 国际化域名可能与经过实体编码的 HTML 一同出现,但域名本身通常使用 Punycode,而不是 HTML 实体。
为什么 HTML 实体解码失败或出现乱码?
解码失败通常是因为输入格式有误、使用了其他编码方案,或包含多层编码。请检查原始文本中是否存在命名或数字形式的 HTML 字符引用,不要在未核对结果的情况下反复转换。
- 引用格式错误:缺少 & 符号、数字符号或分号,都可能导致引用无法识别。可以将文本与 & 或 & 等形式进行比较。
- 输入被重复编码:像 &lt; 这样的文本,解码一次后会得到 <,需要再有意解码一次才会变成小于号。
- 字符集不匹配:如果使用了错误的字符编码来解释文本,可能会出现替换符号,或使带重音符号的字符显示异常。
- 格式不正确:包含百分号的文本可能经过了 URL 编码。由字母、数字、加号、斜杠组成,或末尾带有等号的长字符串,则可能是 Base64。
- 如果输入是 Base64,可能使用了错误的变体或字母表:URL 安全 Base64 使用的字符与标准 Base64 不同。缺少填充字符也可能导致某些解码器失败。这些问题不属于 HTML 实体语法,需要使用 Base64解码工具处理。
常见问题
为什么 看起来和普通空格一样?
因为它表示不换行空格,通常看起来与普通空格相同,但会阻止文本在该位置换行。编辑器可能会在不显示任何提示的情况下保留它,因此排查空格问题时,请查看源代码或检查具体字符。
HTML 实体名称区分大小写吗?
区分。命名字符引用有固定写法,大小写可能决定引用能否被识别。请使用正式规定的准确名称并保留分号,不要依赖浏览器的错误恢复机制。
每个带重音符号的字母都需要写成实体吗?
不需要。正确声明为 UTF-8 的 HTML 文档可以直接包含 é、£ 和 中文 等字符。当标记语法、旧系统或特定发布规则要求使用实体时,实体仍然有用。
HTML 实体可以用在 XML 中吗?
只有少量命名实体在 XML 中预定义,包括 &、<、>、" 和 '。许多在 HTML 中有效的名称,在 XML 中并不有效,除非文档类型对其进行了定义。因此,数字字符引用通常是更稳妥的选择。
实体转换工具能修复损坏的 HTML 吗?
不能。它可以转换实体引用,但不会补全标签、修正嵌套关系或验证文档。转换后,请检查周围的标记。如果网页仍有异常,请使用 HTML 验证工具。
最后检查
确认源内容使用的是 HTML 命名字符引用还是数字字符引用,只转换所需的字符引用层,并将结果与预期显示的文本进行比较。将解码内容放入正式网页前,请结合实际 HTML 上下文,检查结果中出现的尖括号、引号和 & 符号。