HTML enhedskonverter
HTML enhedskonverter er et gratis værktøj, der konverterer mellem HTML-tegnreferencer og afkodede tegn til brug på websider, i indholdssystemer og i andre tekstbaserede formater.
Hvad er HTML-entiteter, og hvorfor bruges de?
HTML-entiteter repræsenterer tegn som tekst, der kan skelnes fra HTML-kode. En HTML-tegnreference begynder normalt med et og-tegn og slutter med et semikolon. Det kan være en navngiven tegnreference som & for et og-tegn eller en numerisk tegnreference som £ for pundtegnet.
De er nyttige, når et tegn har en særlig betydning i HTML. Et almindeligt mindre end-tegn kan blive opfattet som begyndelsen på et tag og kan derfor skrives som <. Tegnreferencer gør det også muligt at angive bestemte tegn i HTML eller kompatibel markup uden at forveksle dem med markup eller kontrolsyntaks.
Entitetskodning er ikke kryptering og holder ikke oplysninger hemmelige. Alle kan læse eller afkode en entitetsreference, så metoden må aldrig bruges til at skjule adgangskoder, personoplysninger eller fortroligt indhold.
Hvordan bruger jeg HTML enhedskonverter?
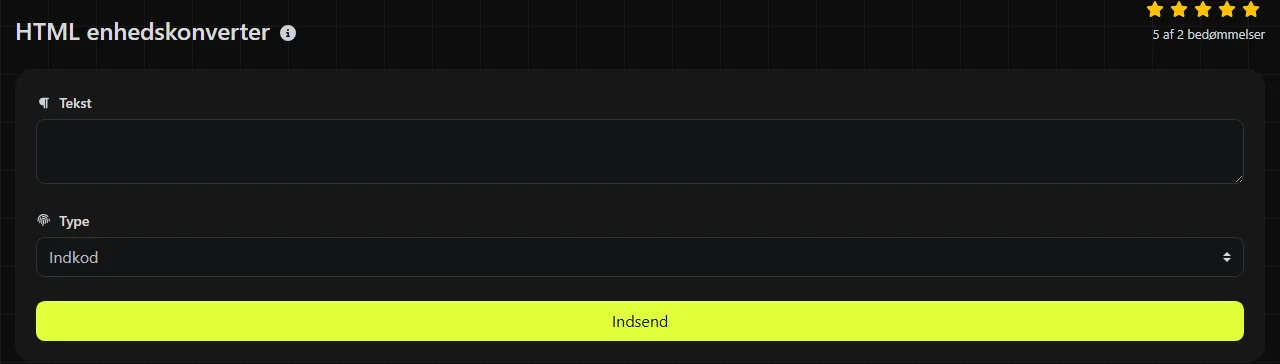
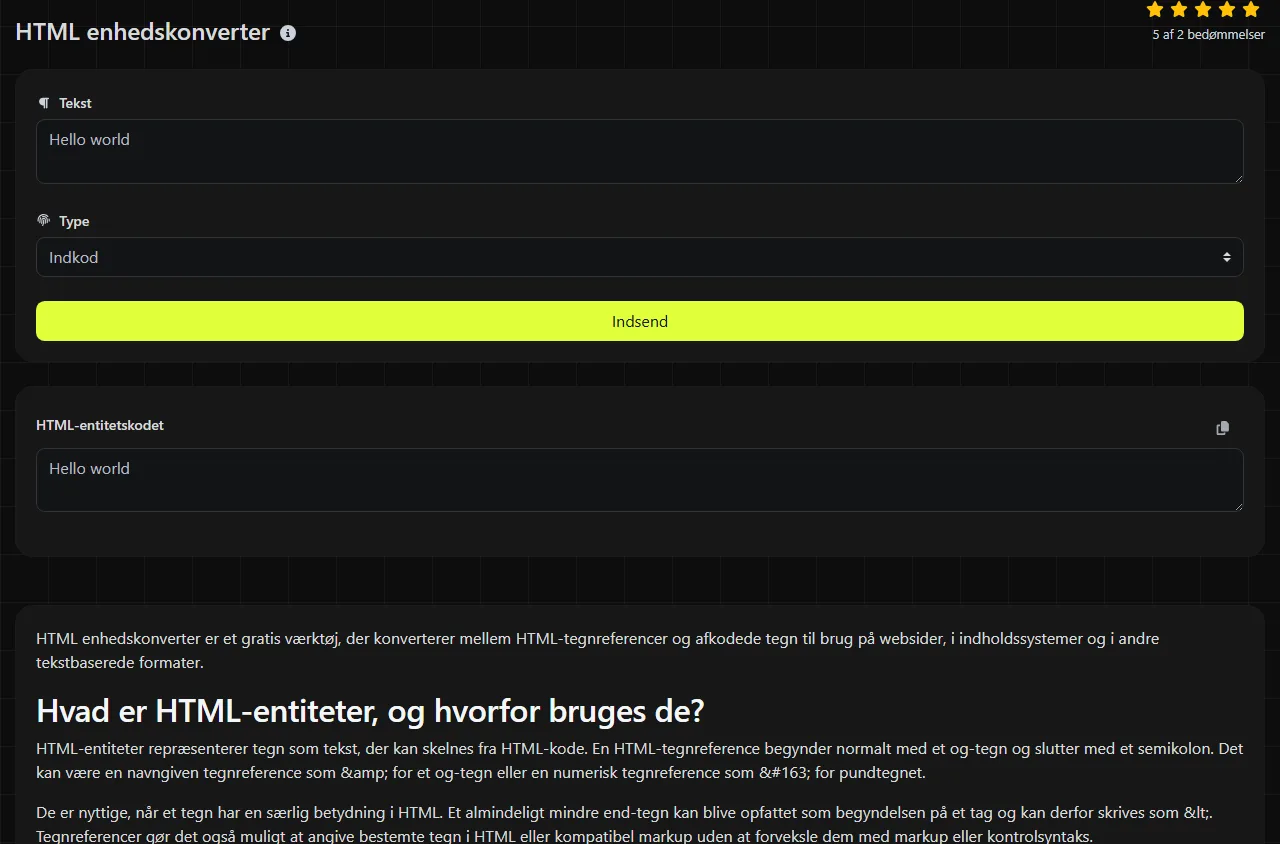
Indtast den relevante tekst i feltet Indkod eller Afkod, og se derefter det tilhørende resultat under HTML-entitetskodet eller HTML-entitetsafkodet. Brug det kodede resultat, når tekst skal indsættes i en relevant HTML-tekst- eller attributkontekst. Brug det afkodede resultat, når du har brug for de tegn, som eksisterende entiteter repræsenterer.
Konverteringen foregår på serveren. Dit input sendes til serveren via HTTPS og bliver ikke gemt.
Kontrollér først, om du faktisk har brug for HTML-entiteter. En værdi i en forespørgselsstreng skal normalt URL-procentkodes i stedet, mens et internationaliseret domæne bruger Punycode. URL-afkoder og IDN Punycode konverter er beregnet til disse to formater.
Hvordan ser et kodet eller afkodet resultat ud?
Et afkodet resultat erstatter genkendte entitetsreferencer med de tegn, de repræsenterer. I den kodede form repræsenteres tegnene med entitetssyntaks.
Input: <p>Tea & cake</p>
Afkodet output: <p>Tea & cake</p>
Vinkelparenteserne i det afkodede resultat er tegn, der kan blive fortolket som HTML-markup, hvis resultatet indsættes som HTML på en side. Afkodning renser ikke indholdet, fjerner ikke scripts og gør ikke HTML fra en kilde, du ikke har tillid til, sikkert. Behandl det afkodede materiale efter den sammenhæng, det skal bruges i.
Eksempler og input, der kan give problemer
Navngivne entiteter og numeriske tegnreferencer kan repræsentere det samme tegn på forskellige måder. Eksempelvis er & en navngiven reference til et og-tegn, mens & er den decimale numeriske reference, og & er den hexadecimale form.
- Almindelige mellemrum og tal skrevet direkte er ikke entitetsreferencer og forbliver normalt uændret tekst.
- Tegnsætning ændres kun, når den forekommer som en genkendt entitetsreference eller bevidst bliver kodet.
- Bogstaver med accent, ikke-latinske skriftsystemer og emojis kan repræsenteres med numeriske tegnreferencer, som angiver Unicode-kodepunkter uafhængigt af HTML-kildens tegnkodning. Korrekt visning afhænger af skrifttypeunderstøttelse, mens tegnkodningen har betydning, hvis det afkodede resultat gemmes eller overføres.
Husk det afsluttende semikolon, når du skriver entiteter. Browsere accepterer visse referencer uden semikolon i begrænsede sammenhænge, men denne forkortede form kan være tvetydig og fungerer mindre pålideligt på tværs af parsere.
Hvor møder man HTML-entiteter i praksis?
HTML-entiteter forekommer ofte i HTML-kildekode, indholdsstyringssystemer, rich text-editorer og HTML-mails. I WordPress' kodevisning kan du eksempelvis se for et hårdt mellemrum eller &, når et og-tegn skal bevares i markuppen.
De kan også forekomme i data, som transporteres i et andet format. Det skaber flere kodningslag, som skal behandles i den rigtige rækkefølge.
- Et JSON-dataobjekt kan indeholde et HTML-fragment, hvor teksten bruger entiteter. Escape-sekvenser i JSON og afkodning af HTML-entiteter er to forskellige handlinger.
- En forespørgselsstreng kan indeholde procentkodet HTML. Afkod URL-laget, før du vurderer, om den resulterende tekst også indeholder entiteter.
- En data-URI kan indeholde HTML eller anden tekst med entiteter, selv om selve URI'en kan være procentkodet eller bruge Base64.
- En HTML-mail kan kode synlig tegnsætning og samtidig bruge MIME-overførselskodning under transporten.
- Et internationaliseret domæne kan stå ved siden af entitetskodet HTML, men selve domænet repræsenteres normalt med Punycode og ikke med HTML-entiteter.
Hvorfor mislykkes afkodningen eller giver ulæseligt resultat?
Afkodning mislykkes som regel, fordi inputtet er ugyldigt, bruger en anden kodningsmetode eller indeholder flere kodningslag. Undersøg den oprindelige tekst for navngivne eller numeriske HTML-tegnreferencer i stedet for at gentage konverteringen uden at kontrollere resultatet.
- Ugyldig reference: Hvis et og-tegn, nummertegn eller semikolon mangler, bliver referencen muligvis ikke genkendt. Sammenlign teksten med former som & eller &.
- Dobbeltkodet input: Tekst som &lt; kan ved første afkodning blive til < og kræver derefter endnu en bevidst afkodning for at blive til et mindre end-tegn.
- Forkert tegnsæt: Tekst, der fortolkes med en forkert tegnkodning, kan vise erstatningstegn eller ødelagte bogstaver med accent.
- Forkert format: Tekst med procenttegn kan være URL-kodet. En lang sekvens af bogstaver, tal, plustegn og skråstreger eller med lighedstegn til sidst kan være Base64.
- Hvis inputtet er Base64, bruges den forkerte variant eller det forkerte alfabet: URL-sikker Base64 bruger andre tegn end almindelig Base64. Manglende udfyldning kan også få visse afkodere til at fejle. Disse problemer har ikke noget med HTML-entitetssyntaks at gøre og kræver en Base64 dekoder.
Ofte stillede spørgsmål
Hvorfor ligner et almindeligt mellemrum?
Det repræsenterer et hårdt mellemrum, som normalt ligner et almindeligt mellemrum, men forhindrer et linjeskift på det pågældende sted. Editorer kan bevare tegnet uden at gøre det synligt, så undersøg kildevisningen eller de konkrete tegn, når du fejlsøger problemer med mellemrum.
Skelner HTML-entitetsnavne mellem store og små bogstaver?
Ja. Navngivne tegnreferencer har en fast stavemåde, og brugen af store eller små bogstaver kan afgøre, om en reference bliver genkendt. Brug det nøjagtige officielle navn, og medtag semikolonet i stedet for at forlade dig på browserens fejlkorrektion.
Skal alle bogstaver med accent skrives som entiteter?
Nej. Et HTML-dokument med korrekt angivet UTF-8 kan indeholde tegn som é, £ og 中文 direkte. Entiteter er stadig nyttige, når markupsyntaksen, et ældre system eller en bestemt udgivelsesregel kræver dem.
Kan HTML-entiteter bruges i XML?
Kun et lille antal navngivne entiteter er foruddefineret i XML, herunder &, <, >, " og '. Mange navne, der er gyldige i HTML, er ugyldige i XML, medmindre de defineres af en dokumenttype. Derfor er numeriske tegnreferencer ofte det sikrere valg.
Kan en entitetskonverter reparere ugyldig HTML?
Nej. Den kan konvertere entitetsreferencer, men den afstemmer ikke tags, retter ikke indlejring og validerer ikke dokumentet. Efter konverteringen bør du undersøge den omgivende markup og bruge en HTML-validator, hvis siden stadig opfører sig uventet.
Afsluttende kontrol
Kontrollér, om kilden bruger navngivne eller numeriske HTML-tegnreferencer. Konvertér kun det nødvendige tegnreferencelag, og sammenlign resultatet med den tekst, der skal være synlig. Før du indsætter afkodet indhold på en aktiv side, skal du gennemgå eventuelle vinkelparenteser, anførselstegn og og-tegn i deres faktiske HTML-kontekst.
Populære værktøjer
Opret din egen tilpassede signatur og download den nemt med vores signaturgeneratorværktøj til personlige e-signaturer.
Beregn størrelsen af enhver tekst i Bytes (B), Kilobytes (KB) eller Megabytes (MB) ved hjælp af vores tekststørrelsesberegner.
Brug værktøjet til reverse IP-opslag for hurtigt og nemt at finde det domæne eller den vært, der er knyttet til en IP-adresse.
Brug vores ping-værktøj til hurtigt og effektivt at tjekke status og svartid for enhver hjemmeside, server eller port.
Digily Links IP-opslagsværktøj giver detaljerede oplysninger om enhver IP-adresse. Brug denne gratis online tjeneste til at få omfattende IP-data.
Generer dit gratis WhatsApp-link øjeblikkeligt med vores WhatsApp Link Generator. Tilføj en tilpasset besked og start chats med ét klik. Ingen login eller kodning krævet.