Конвертор на HTML ентитети
Лесно кодирайте или декодирайте HTML ентитети с нашия инструмент за конвертиране на HTML ентитети за точно управление на уеб съдържанието.
Конверторът на HTML ентитети е безплатен инструмент, който преобразува HTML знакови референции в декодирани знаци и обратно. Подходящ е за уеб страници, системи за управление на съдържание и други текстови формати.
Какво представляват HTML ентитетите и защо се използват?
HTML ентитетите представят знаци чрез текст, който HTML може да различи от собствения си маркиращ код. HTML знаковата референция обикновено започва с амперсанд и завършва с точка и запетая. Тя може да бъде именувана, например & за амперсанд, или числова, например £ за знака за британска лира.
Те са полезни, когато даден знак има специално значение в HTML. Знакът "по-малко от", изписан директно, може да бъде разпознат погрешно като начало на таг, затова може да се запише като <. Знаковите референции позволяват и представянето на определени знаци в HTML или съвместим маркиращ език, без те да бъдат объркани с маркиращ код или управляващ синтаксис.
Кодирането чрез ентитети не е криптиране и не осигурява поверителност. Всеки може да прочете или декодира такава референция, затова никога не го използвай за скриване на пароли, лични данни или поверително съдържание.
Как се използва конверторът на HTML ентитети?
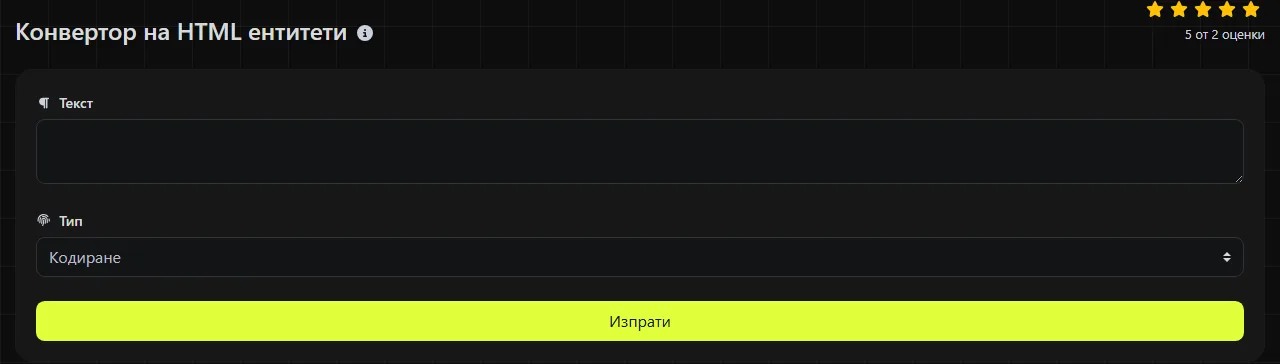
Въведи съответния текст в полето Кодиране или Декодиране, след което виж резултата в Кодирано като HTML ентитети или Декодирани HTML ентитети. Използвай кодирания резултат, когато текстът трябва да се постави в подходящ HTML текстов или атрибутен контекст. Използвай декодирания резултат, когато са ти нужни знаците, представени от съществуващите ентитети.
Преобразуването се извършва на сървъра. Въведените данни се изпращат до него през HTTPS и не се съхраняват.
Преди преобразуването провери дали действително са ти нужни HTML ентитети. Стойност в низ за заявка обикновено изисква URL процентно кодиране, а интернационализиран домейн използва Punycode. За тези два формата са предназначени съответно Декодерът на URL адреси и IDN Punycode конверторът.
Как изглежда кодираният или декодираният резултат?
При декодиране разпознатите референции се заменят със знаците, които представят. При кодиране знаците се представят чрез синтаксиса на HTML ентитетите.
Вход: <p>Tea & cake</p>
Декодиран резултат: <p>Tea & cake</p>
Ъгловите скоби в декодирания резултат са знаци, които могат да се превърнат в HTML маркиращ код, ако бъдат вмъкнати в страница като HTML. Декодирането не пречиства съдържанието, не премахва скриптове и не прави недоверен HTML безопасен. Обработвай декодираните данни според контекста, в който ще се използват.
Практически примери и проблемни входни данни
Именуваните ентитети и числовите знакови референции могат да представят един и същ знак по различни начини. Например & е именувана референция за амперсанд, & е десетичната му числова референция, а & е шестнадесетичният вариант.
- Обикновените интервали и изписаните директно числа не са референции към ентитети и по правило остават непроменен текст.
- Пунктуационните знаци се променят само ако са представени чрез разпозната референция или бъдат умишлено кодирани.
- Букви с диакритични знаци, писмености извън латиницата и емоджита могат да се представят чрез числови знакови референции. Те обозначават Unicode кодови точки независимо от кодирането на HTML източника. Правилното показване зависи от поддръжката на шрифта, а знаковото кодиране е от значение, ако декодираният резултат се съхранява или пренася.
Когато подготвяш ентитети, добавяй точката и запетаята в края. Браузърите приемат някои референции без нея в ограничени контексти, но този съкратен запис може да бъде двусмислен и е по-малко съвместим с различни анализатори.
Къде се срещат HTML ентитети на практика?
HTML ентитетите често се срещат в изходен HTML код, системи за управление на съдържание, редактори за форматиран текст и HTML имейли. Например в изгледа за редактиране на код в WordPress може да видиш за непрекъсваем интервал или &, когато амперсандът трябва да се запази в маркиращия код.
Ентитети може да има и в данни, пренасяни чрез друг формат. Така се получават няколко слоя на кодиране, които трябва да се обработят в правилния ред.
- JSON данните може да съдържат HTML фрагмент с ентитети в текста. Екранирането в JSON и декодирането на HTML ентитети са отделни операции.
- Низът за заявка може да съдържа процентно кодиран HTML. Първо декодирай URL слоя, а след това провери дали полученият текст съдържа и ентитети.
- URI с данни може да съдържа HTML или друг текст с ентитети, въпреки че самият URI може да използва процентно кодиране или Base64.
- HTML имейл може да кодира видимите пунктуационни знаци, като същевременно използва MIME транспортно кодиране за пренос.
- Интернационализиран домейн може да се среща до HTML, кодиран чрез ентитети, но самият домейн обикновено се представя с Punycode, а не с HTML ентитети.
Защо декодирането на HTML ентитети не работи или показва неразбираеми знаци?
Декодирането обикновено се проваля, защото входните данни са неправилно оформени, използват друг начин на кодиране или съдържат повече от един слой на кодиране. Потърси в оригиналния текст именувани или числови HTML знакови референции, вместо многократно да прилагаш преобразувания, без да проверяваш резултата.
- Неправилно оформена референция: Липсващ амперсанд, знак за номер или точка и запетая може да попречи на разпознаването. Сравни текста с форми като & или &.
- Двойно кодирани данни: Текст като &lt; може при първото декодиране да стане <, след което е нужно умишлено второ декодиране, за да се получи знакът "по-малко от".
- Несъответствие в знаковото кодиране: Текст, интерпретиран с неправилно знаково кодиране, може да показва заместващи символи или повредени букви с диакритични знаци.
- Неправилен формат: Текст със знаци за процент може да е URL кодиран. Дълга поредица от букви, цифри, знаци плюс, наклонени черти или знаци за равенство в края може да е Base64.
- При Base64 входни данни е използван неправилен вариант или азбука: Безопасният за URL вариант на Base64 използва знаци, различни от стандартния Base64. Липсващото допълване също може да попречи на някои декодери. Тези проблеми не са част от синтаксиса на HTML ентитетите и изискват Base64 декодер.
Често задавани въпроси
Защо изглежда като обикновен интервал?
Той представя непрекъсваем интервал, който обикновено изглежда като нормален, но не позволява пренасяне на нов ред на това място. Редакторите може да го запазят, без да го показват видимо. Ако проверяваш проблем с разстоянията, отвори изгледа на изходния код или прегледай какъв точно знак е използван.
Има ли значение регистърът на буквите в имената на HTML ентитетите?
Да. Именуваните знакови референции имат точно определен правопис и регистърът може да повлияе дали ще бъдат разпознати. Използвай точно публикуваното име и добавяй точката и запетаята, вместо да разчиташ браузърът да поправи грешката.
Трябва ли да използвам ентитети за всяка буква с диакритичен знак?
Не. HTML документ с правилно декларирано UTF-8 кодиране може директно да съдържа знаци като é, £ и 中文. Ентитетите остават полезни, когато ги изисква синтаксисът на маркиращия език, по-стара система или конкретно правило за публикуване.
Мога ли да използвам HTML ентитети в XML?
В XML предварително са дефинирани само малък брой именувани ентитети, сред които &, <, >, " и '. Много имена, валидни в HTML, са невалидни в XML, освен ако не са дефинирани от типа на документа. Затова числовите знакови референции често са по-сигурният избор.
Може ли конверторът на ентитети да поправи невалиден HTML?
Не. Той може да преобразува референции към ентитети, но не балансира тагове, не коригира влагането им и не валидира документа. След преобразуването провери околния маркиращ код и използвай HTML валидатор, ако страницата продължава да се държи неочаквано.
Последни проверки
Потвърди дали източникът използва именувани или числови HTML знакови референции, преобразувай само необходимия слой и сравни резултата с текста, който трябва да се вижда. Преди да поставиш декодирано съдържание в работеща страница, провери получените ъглови скоби, кавички и амперсанди в реалния им HTML контекст.
Популярни инструменти
Създайте свой собствен подпис и го изтеглете лесно с нашия инструмент за генериране на подписи за персонализирани електронни подписи.
Изчислете размера на всеки текст в байтове (B), килобайти (KB) или мегабайти (MB) с помощта на нашия инструмент за изчисляване на размера на текста.
Използвайте инструмента за обратна IP проверка, за да намерите домейна или хоста, свързан с всеки IP адрес бързо и лесно.
Използвайте нашия инструмент за пинг, за да проверите състоянието и времето за отговор на всеки уебсайт, сървър или порт бързо и ефективно.
Инструментът за търсене на IP на Digily Link предоставя подробна информация за всеки IP адрес. Използвайте тази безплатна онлайн услуга, за да получите изчерпателни данни за IP.
Генерирайте своя безплатен WhatsApp линк мигновено с нашия генератор на WhatsApp линкове. Добавете персонализирано съобщение и започнете чатове с едно кликване. Без нужда от вход или програмиране.