Convertor de entități HTML
Codificați sau decodificați cu ușurință entitățile HTML cu instrumentul nostru de conversie a entităților HTML pentru o gestionare precisă a conținutului web.
Convertorul de entități HTML este un instrument gratuit care transformă referințele de caractere HTML în caractere decodificate și invers, pentru utilizare în pagini web, sisteme de gestionare a conținutului și alte formate bazate pe text.
Ce sunt entitățile HTML și de ce există?
Entitățile HTML reprezintă caractere printr-o formă textuală pe care HTML o poate deosebi de propriul marcaj. O referință de caracter HTML începe de obicei cu un ampersand și se termină cu punct și virgulă. Poate fi o referință denumită, precum & pentru un ampersand, sau una numerică, precum £ pentru simbolul lirei sterline.
Sunt utile atunci când un caracter are o semnificație specială în HTML. Semnul mai mic decât, introdus ca atare, ar putea fi confundat cu începutul unei etichete, așa că poate fi scris ca <. Referințele de caractere permit și reprezentarea anumitor caractere în HTML sau în formate de marcaj compatibile, fără ca acestea să fie confundate cu marcajul ori cu sintaxa de control.
Codificarea entităților nu este criptare și nu oferă confidențialitate. Oricine poate citi sau decodifica o referință de entitate, așa că nu o folosi niciodată pentru a ascunde parole, date cu caracter personal sau conținut confidențial.
Cum folosesc convertorul de entități HTML?
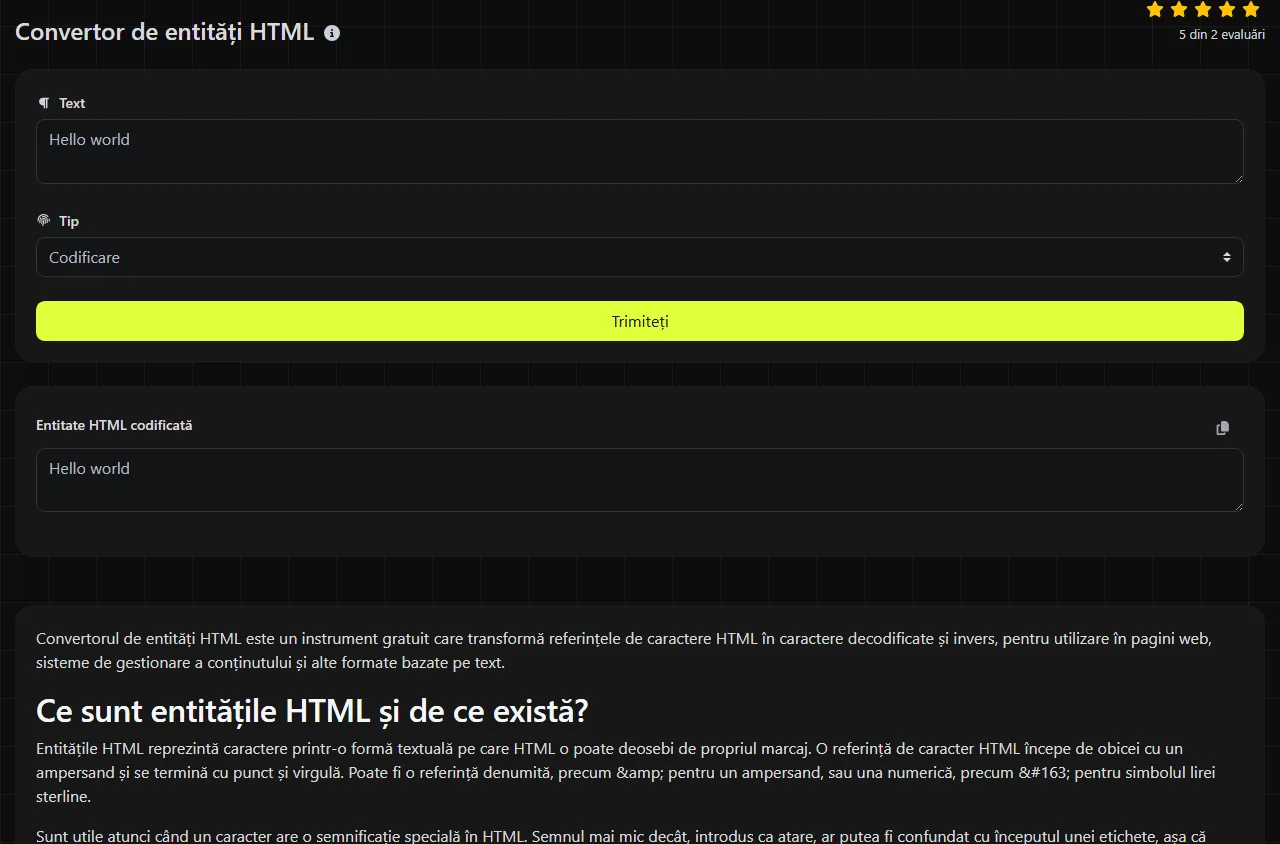
Introdu textul relevant în câmpul Codificare sau Decodificare, apoi consultă rezultatul corespunzător din Entitate HTML codificată sau Entitate HTML decodificată. Folosește rezultatul codificat când textul trebuie afișat într-un context HTML adecvat, fie în conținut, fie într-un atribut. Folosește rezultatul decodificat când ai nevoie de caracterele reprezentate de entitățile existente.
Conversia are loc pe server. Datele introduse sunt trimise către server prin HTTPS și nu sunt stocate.
Înainte de conversie, verifică dacă ai într-adevăr nevoie de entități HTML. O valoare dintr-un șir de interogare necesită de obicei codificare URL procentuală, iar un domeniu internaționalizat folosește Punycode. Pentru aceste formate există Decodorul URL și, respectiv, Convertorul IDN Punycode.
Cum arată un rezultat codificat sau decodificat?
Un rezultat decodificat înlocuiește referințele de entități recunoscute cu acele caractere pe care le reprezintă, iar forma codificată reprezintă caracterele folosind sintaxa entităților.
Intrare: <p>Tea & cake</p>
Rezultat decodificat: <p>Tea & cake</p>
Parantezele unghiulare din rezultatul decodificat sunt caractere care pot deveni marcaj HTML dacă rezultatul este inserat într-o pagină ca HTML. Decodificarea nu igienizează conținutul, nu elimină scripturile și nu face sigur un cod HTML dintr-o sursă care nu este de încredere. Tratează materialul decodificat în funcție de contextul în care va fi folosit.
Exemple practice și situații dificile
Entitățile denumite și referințele numerice de caractere pot reprezenta același caracter în moduri diferite. De exemplu, & este referința denumită pentru un ampersand, & este referința numerică zecimală, iar & este forma hexazecimală.
- Spațiile obișnuite și numerele introduse ca atare nu sunt referințe de entități și, în mod normal, rămân text obișnuit.
- Semnele de punctuație se schimbă numai când apar ca referințe de entități recunoscute sau când sunt codificate în mod intenționat.
- Literele cu diacritice, scrierile cu alte alfabete și emojiurile pot fi reprezentate prin referințe numerice de caractere, care identifică punctele de cod Unicode independent de codificarea sursei HTML. Afișarea corectă depinde de caracterele acceptate de font, iar codificarea caracterelor contează dacă rezultatul decodificat este stocat sau transmis.
Când pregătești entitățile, include punctul și virgula de la final. Browserele acceptă unele referințe fără punct și virgulă în contexte limitate, însă această prescurtare poate fi ambiguă și este mai puțin portabilă între diferite analizoare sintactice.
Unde întâlnesc entități HTML în practică?
Entitățile HTML apar frecvent în codul sursă HTML, în sisteme de gestionare a conținutului, în editoare de text îmbogățit și în mesaje e-mail HTML. De exemplu, vizualizarea de cod din WordPress poate conține pentru un spațiu fără întrerupere sau & atunci când un ampersand trebuie păstrat în marcaj.
Entitățile pot apărea și în date transportate prin alt format. Astfel se formează mai multe niveluri de codificare, care trebuie prelucrate în ordinea corectă.
- Un set de date JSON poate conține un fragment HTML al cărui text include entități. Escaparea JSON și decodificarea entităților HTML sunt operațiuni distincte.
- Un șir de interogare poate conține HTML codificat procentual. Decodifică mai întâi nivelul URL, apoi verifică dacă textul rezultat conține și entități.
- Un URI de date poate conține HTML sau alt text cu entități, deși URI-ul propriu-zis poate folosi codificare procentuală sau Base64.
- Un mesaj e-mail HTML poate codifica semnele de punctuație vizibile și poate folosi în același timp codificarea de transfer MIME pentru transport.
- Un domeniu internaționalizat poate apărea lângă cod HTML cu entități, însă domeniul propriu-zis este reprezentat în mod normal prin Punycode, nu prin entități HTML.
De ce eșuează decodificarea entităților HTML sau produce text indescifrabil?
Decodificarea eșuează de obicei deoarece datele de intrare sunt incorecte, folosesc altă schemă de codificare sau conțin mai multe niveluri de codificare. Verifică textul original pentru referințe de caractere HTML denumite ori numerice, în loc să aplici conversia în mod repetat fără să examinezi rezultatul.
- Referință incorectă: Lipsa ampersandului, a semnului diez sau a punctului și virgulei poate împiedica recunoașterea. Compară textul cu forme precum & sau &.
- Intrare codificată de două ori: Un text precum &lt; poate deveni < după prima decodificare și necesită încă o trecere intenționată pentru a deveni semnul mai mic decât.
- Codificare de caractere nepotrivită: Textul interpretat cu o codificare greșită poate afișa simboluri de înlocuire sau caractere cu diacritice corupte.
- Format greșit: Textul care conține semne procent poate fi codificat URL. O secvență lungă alcătuită din litere, cifre, semne plus, bare oblice sau semne egal la final poate fi Base64.
- Dacă intrarea este Base64, variantă sau alfabet greșit: Base64 sigur pentru URL folosește alte caractere decât Base64 standard. Lipsa caracterelor de completare poate împiedica și ea funcționarea unor decodoare. Aceste probleme nu țin de sintaxa entităților HTML și necesită un Decodor Base64.
Întrebări frecvente
De ce arată ca un spațiu obișnuit?
reprezintă un spațiu fără întrerupere. De obicei arată ca un spațiu normal, dar împiedică trecerea la un rând nou în acel punct. Unele editoare îl păstrează fără să-l evidențieze, așa că, pentru a identifica problemele de spațiere, consultă vizualizarea sursă sau examinează caracterele.
Numele entităților HTML fac diferența între litere mari și mici?
Da. Referințele de caractere denumite au forme ortografice bine definite, iar folosirea literelor mari sau mici poate determina dacă o referință este recunoscută. Folosește numele publicat exact și include punctul și virgula, în loc să te bazezi pe corectarea automată a erorilor de către browser.
Trebuie să folosesc entități pentru fiecare literă cu diacritice?
Nu. Un document HTML UTF-8 declarat corect poate conține direct caractere precum é, £ și 中文. Entitățile rămân utile atunci când sunt impuse de sintaxa marcajului, de un sistem mai vechi sau de o anumită regulă de publicare.
Pot folosi entități HTML în XML?
În XML este predefinit doar un set restrâns de entități denumite, printre care &, <, >, " și '. Multe nume valide în HTML nu sunt valide în XML decât dacă sunt definite de un tip de document, așa că referințele numerice de caractere sunt adesea alegerea mai sigură.
Poate un convertor de entități să repare codul HTML defect?
Nu. Poate converti referințele de entități, dar nu închide corect etichetele, nu repară imbricarea și nu validează documentul. După conversie, verifică marcajul din jur și folosește un validator HTML dacă pagina continuă să se comporte neașteptat.
Verificări finale
Confirmă dacă sursa folosește referințe de caractere HTML denumite sau numerice, convertește doar nivelul necesar de referințe și compară rezultatul cu textul care ar trebui să fie vizibil. Înainte de a introduce conținutul decodificat într-o pagină publicată, verifică parantezele unghiulare, ghilimelele și ampersandurile rezultate în contextul HTML în care vor fi folosite.
Instrumente populare
Creați-vă propria semnătură personalizată și descărcați-o ușor cu instrumentul nostru de generare a semnăturilor pentru semnături electronice personalizate.
Calculează dimensiunea oricărui text în Byți (B), Kilobyți (KB) sau Megabyți (MB) folosind instrumentul nostru de calcul al dimensiunii textului.
Utilizați instrumentul de căutare inversă IP pentru a găsi rapid și ușor domeniul sau gazda asociată cu orice adresă IP.
Folosiți instrumentul nostru de ping pentru a verifica rapid și eficient starea și timpul de răspuns al oricărui site web, server sau port.
Instrumentul de căutare IP al Digily Link oferă informații detaliate despre orice adresă IP. Folosește acest serviciu online gratuit pentru a obține date IP cuprinzătoare.
Generează instantaneu linkul tău gratuit de WhatsApp cu Generatorul nostru de Linkuri WhatsApp. Adaugă un mesaj personalizat și începe conversațiile cu un singur clic. Fără autentificare sau codare necesară.