एचटीएमएल एंटिटी कन्वर्टर
हमारे HTML एंटिटी कन्वर्टर टूल के साथ HTML एंटिटी को आसानी से एन्कोड या डिकोड करें ताकि वेब सामग्री प्रबंधन सटीक हो सके।
एचटीएमएल एंटिटी कन्वर्टर एक मुफ़्त टूल है, जो वेब पेजों, कॉन्टेंट सिस्टम और दूसरे टेक्स्ट-आधारित फ़ॉर्मैट में इस्तेमाल के लिए HTML कैरेक्टर रेफ़रेंस को सामान्य कैरेक्टर में डिकोड करता है और सामान्य कैरेक्टर को HTML एंटिटी में बदलता है।
HTML एंटिटी क्या हैं और इनकी ज़रूरत क्यों पड़ती है?
HTML एंटिटी किसी कैरेक्टर को ऐसे टेक्स्ट के रूप में दिखाती हैं, जिसे HTML अपने मार्कअप से अलग पहचान सके। HTML कैरेक्टर रेफ़रेंस आम तौर पर एम्परसैंड से शुरू होता है और सेमीकोलन पर खत्म होता है। यह नाम वाला कैरेक्टर रेफ़रेंस हो सकता है, जैसे एम्परसैंड के लिए &, या संख्यात्मक कैरेक्टर रेफ़रेंस, जैसे पाउंड चिह्न के लिए £।
ये तब काम आती हैं, जब किसी कैरेक्टर का HTML में विशेष अर्थ हो। उदाहरण के लिए, सीधे लिखा गया less-than चिह्न किसी टैग की शुरुआत समझा जा सकता है, इसलिए इसे < के रूप में लिखा जा सकता है। कैरेक्टर रेफ़रेंस की मदद से सिस्टम किसी कैरेक्टर को HTML या उसके अनुकूल मार्कअप में दिखा सकते हैं, बिना उसे मार्कअप या कंट्रोल सिंटैक्स समझे।
एंटिटी एनकोडिंग कोई एन्क्रिप्शन नहीं है और इससे जानकारी गुप्त नहीं रहती। कोई भी एंटिटी रेफ़रेंस को पढ़ या डिकोड कर सकता है, इसलिए पासवर्ड, निजी डेटा या गोपनीय सामग्री छिपाने के लिए इसका इस्तेमाल कभी न करें।
एचटीएमएल एंटिटी कन्वर्टर का इस्तेमाल कैसे करें?
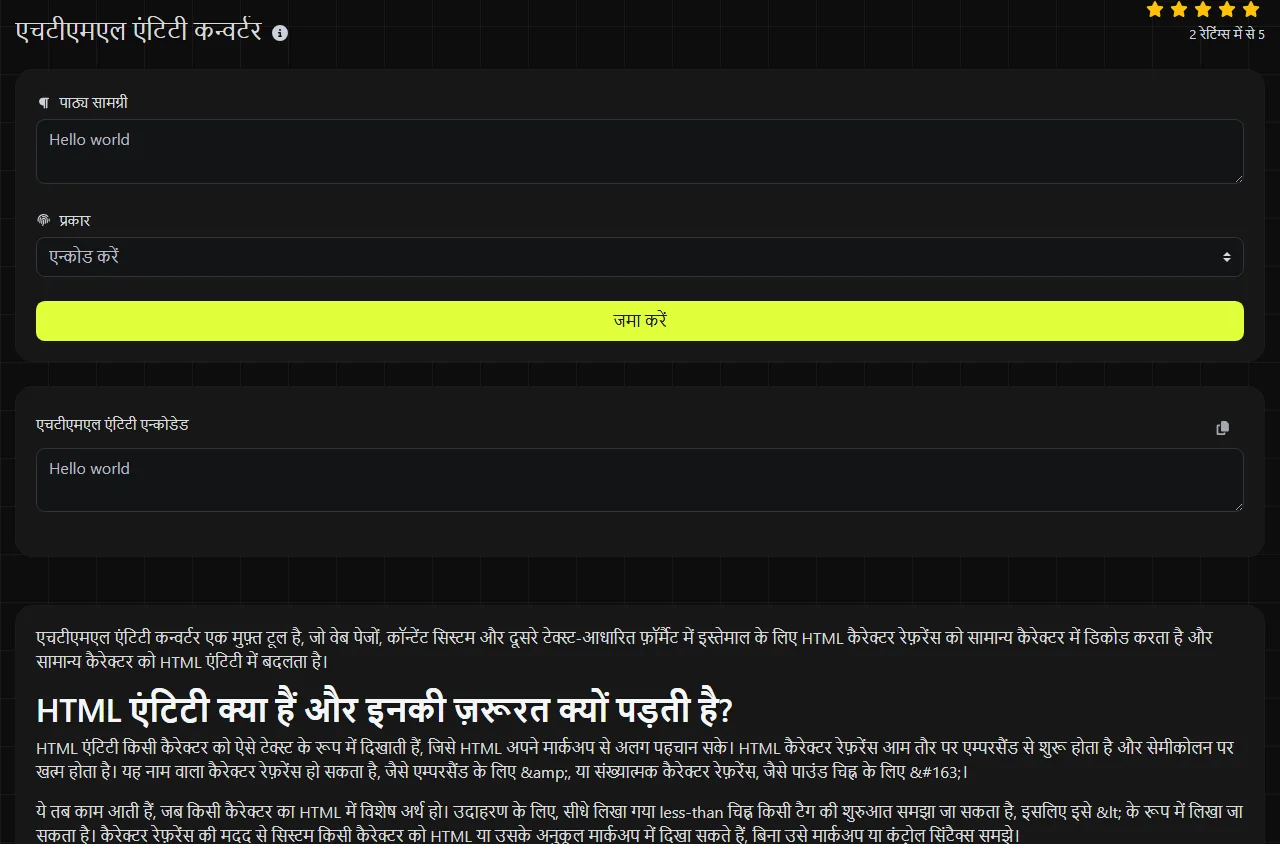
संबंधित टेक्स्ट को एन्कोड करें या Decode फ़ील्ड में डालें। फिर उससे जुड़ा एचटीएमएल एंटिटी एन्कोडेड या HTML एंटिटी डिकोड किया गया नतीजा देखें। जब टेक्स्ट को किसी उपयुक्त HTML टेक्स्ट या एट्रिब्यूट संदर्भ में रखना हो, तब एनकोड किया हुआ आउटपुट इस्तेमाल करें। मौजूदा एंटिटी जिन कैरेक्टर को दर्शाती हैं, उन्हें पाने के लिए डिकोड किया हुआ आउटपुट इस्तेमाल करें।
कन्वर्ज़न सर्वर पर होता है। आपका इनपुट HTTPS के ज़रिए सर्वर तक जाता है और स्टोर नहीं किया जाता।
कन्वर्ट करने से पहले जांच लें कि आपको वास्तव में HTML एंटिटी की ज़रूरत है या नहीं। क्वेरी स्ट्रिंग की वैल्यू के लिए आम तौर पर URL प्रतिशत-एनकोडिंग चाहिए, जबकि अंतरराष्ट्रीय डोमेन में Punycode इस्तेमाल होता है। इन दोनों फ़ॉर्मैट के लिए क्रमशः यूआरएल डिकोडर और आईडीएन पन्यकोड कन्वर्टर का इस्तेमाल करें।
एनकोड या डिकोड किया हुआ नतीजा कैसा दिखता है?
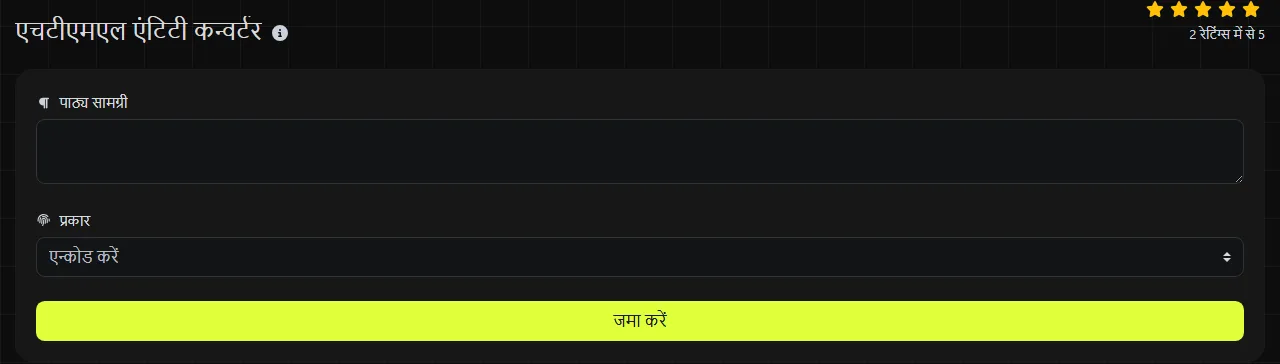
डिकोड किया हुआ नतीजा पहचाने गए एंटिटी रेफ़रेंस को उनके वास्तविक कैरेक्टर से बदल देता है। वहीं, एनकोड किया हुआ रूप कैरेक्टर को एंटिटी सिंटैक्स में दिखाता है।
इनपुट: <p>Tea & cake</p>
डिकोड किया हुआ आउटपुट: <p>Tea & cake</p>
डिकोड किए गए आउटपुट में angle brackets सामान्य कैरेक्टर हैं, लेकिन किसी पेज में HTML के रूप में डालने पर वे HTML मार्कअप बन सकते हैं। डिकोडिंग से कॉन्टेंट साफ़ नहीं होता, स्क्रिप्ट नहीं हटती और अविश्वसनीय HTML सुरक्षित नहीं बनता। डिकोड की गई सामग्री को उसी संदर्भ के अनुसार संभालें, जिसमें उसका इस्तेमाल होना है।
उदाहरण और मुश्किल इनपुट
नाम वाली एंटिटी और संख्यात्मक कैरेक्टर रेफ़रेंस एक ही कैरेक्टर को अलग-अलग तरीकों से दिखा सकते हैं। उदाहरण के लिए, & एम्परसैंड का नाम वाला रेफ़रेंस है, जबकि & उसका दशमलव संख्यात्मक रेफ़रेंस और & हेक्साडेसिमल रूप है।
- सामान्य स्पेस और सीधे लिखी गई संख्याएं एंटिटी रेफ़रेंस नहीं होतीं और आम तौर पर सामान्य टेक्स्ट ही रहती हैं।
- विराम चिह्न तभी बदलता है, जब वह किसी पहचाने गए एंटिटी रेफ़रेंस के रूप में मौजूद हो या उसे जानबूझकर एनकोड किया जाए।
- उच्चारण चिह्न वाले अक्षर, गैर-लैटिन लिपियां और इमोजी संख्यात्मक कैरेक्टर रेफ़रेंस से दिखाए जा सकते हैं। ये HTML स्रोत की एनकोडिंग से स्वतंत्र रूप से Unicode code points की पहचान करते हैं। सही प्रदर्शन फ़ॉन्ट के समर्थन पर निर्भर करता है, जबकि डिकोड किए गए आउटपुट को स्टोर या भेजते समय कैरेक्टर एनकोडिंग भी महत्वपूर्ण होती है।
एंटिटी तैयार करते समय आखिर में सेमीकोलन ज़रूर लगाएं। ब्राउज़र कुछ सीमित संदर्भों में सेमीकोलन के बिना लिखे रेफ़रेंस स्वीकार कर लेते हैं, लेकिन यह छोटा रूप अस्पष्ट हो सकता है और अलग-अलग पार्सर में कम विश्वसनीय होता है।
HTML एंटिटी असल में कहां दिखाई देती हैं?
HTML एंटिटी आम तौर पर HTML स्रोत, कॉन्टेंट मैनेजमेंट सिस्टम, रिच-टेक्स्ट एडिटर और HTML ईमेल में मिलती हैं। उदाहरण के लिए, WordPress के कोड व्यू में non-breaking space के लिए या मार्कअप में एम्परसैंड को सुरक्षित रखने के लिए & दिखाई दे सकता है।
ये किसी दूसरे फ़ॉर्मैट में भेजे जा रहे डेटा के अंदर भी हो सकती हैं। इससे एनकोडिंग की कई परतें बन जाती हैं, जिन्हें सही क्रम में संभालना ज़रूरी है।
- JSON payload में कोई HTML fragment हो सकता है, जिसके टेक्स्ट में एंटिटी शामिल हों। JSON escaping और HTML एंटिटी डिकोडिंग अलग-अलग प्रक्रियाएं हैं।
- किसी query string में प्रतिशत-एनकोड किया हुआ HTML हो सकता है। पहले URL की परत डिकोड करें, फिर तय करें कि मिले हुए टेक्स्ट में एंटिटी भी मौजूद हैं या नहीं।
- data URI में एंटिटी वाला HTML या दूसरा टेक्स्ट हो सकता है, हालांकि URI खुद प्रतिशत-एनकोडिंग या Base64 इस्तेमाल कर सकता है।
- HTML ईमेल में दिखने वाले विराम चिह्न एनकोड किए जा सकते हैं और भेजने के लिए साथ ही MIME transfer encoding का इस्तेमाल भी हो सकता है।
- अंतरराष्ट्रीय डोमेन एंटिटी-एनकोड किए गए HTML के पास दिखाई दे सकता है, लेकिन डोमेन खुद आम तौर पर HTML एंटिटी के बजाय Punycode में लिखा जाता है।
HTML एंटिटी डिकोड क्यों नहीं होती या बेतुका टेक्स्ट क्यों दिखता है?
डिकोडिंग आम तौर पर इसलिए विफल होती है क्योंकि इनपुट गलत बना है, किसी दूसरी एनकोडिंग योजना का इस्तेमाल करता है या उसमें एनकोडिंग की एक से अधिक परतें हैं। नतीजे की जांच किए बिना बार-बार कन्वर्ज़न करने के बजाय मूल टेक्स्ट में नाम वाले या संख्यात्मक HTML कैरेक्टर रेफ़रेंस खोजें।
- गलत बना रेफ़रेंस: एम्परसैंड, number sign या सेमीकोलन न होने पर रेफ़रेंस पहचाना नहीं जा सकता। टेक्स्ट की तुलना & या & जैसे रूपों से करें।
- दो बार एनकोड किया गया इनपुट: &lt; जैसा टेक्स्ट पहली बार डिकोड होने पर < बन सकता है। उसे less-than चिह्न में बदलने के लिए जानबूझकर एक बार और डिकोड करना पड़ेगा।
- कैरेक्टर सेट मेल न खाना: गलत कैरेक्टर एनकोडिंग से पढ़े गए टेक्स्ट में replacement symbols या बिगड़े हुए उच्चारण चिह्न वाले अक्षर दिख सकते हैं।
- गलत फ़ॉर्मैट: प्रतिशत चिह्न वाला टेक्स्ट URL-एनकोड किया हुआ हो सकता है। अक्षरों, अंकों, plus signs, slashes या आखिर में equals signs वाली लंबी स्ट्रिंग Base64 हो सकती है।
- Base64 इनपुट के लिए गलत variant या alphabet: URL-safe Base64 में standard Base64 से अलग कैरेक्टर इस्तेमाल होते हैं। padding न होने पर भी कुछ डिकोडर काम नहीं करते। इन समस्याओं का HTML एंटिटी सिंटैक्स से संबंध नहीं है और इनके लिए बेस64 डिकोडर चाहिए।
अक्सर पूछे जाने वाले सवाल
सामान्य स्पेस जैसा क्यों दिखता है?
यह non-breaking space को दर्शाता है। यह आम तौर पर सामान्य स्पेस जैसा दिखता है, लेकिन उस जगह लाइन को टूटने से रोकता है। एडिटर इसे बिना दिखाए सुरक्षित रख सकते हैं, इसलिए स्पेसिंग की समस्या जांचते समय source view या character inspector का इस्तेमाल करें।
क्या HTML एंटिटी के नाम में बड़े और छोटे अक्षर मायने रखते हैं?
हां। नाम वाले कैरेक्टर रेफ़रेंस की वर्तनी तय होती है और अक्षरों का case बदलने पर रेफ़रेंस की पहचान प्रभावित हो सकती है। ब्राउज़र की error recovery पर निर्भर रहने के बजाय प्रकाशित नाम को बिल्कुल सही लिखें और आखिर में सेमीकोलन लगाएं।
क्या उच्चारण चिह्न वाले हर अक्षर के लिए एंटिटी चाहिए?
नहीं। सही तरीके से घोषित UTF-8 HTML दस्तावेज़ में é, £ और 中文 जैसे कैरेक्टर सीधे लिखे जा सकते हैं। एंटिटी तब भी उपयोगी हैं, जब मार्कअप सिंटैक्स, कोई पुराना सिस्टम या प्रकाशन का खास नियम उनकी मांग करता हो।
क्या XML में HTML एंटिटी इस्तेमाल की जा सकती हैं?
XML में नाम वाली एंटिटी का केवल एक छोटा समूह पहले से परिभाषित है, जिसमें &, <, >, " और ' शामिल हैं। HTML में मान्य कई नाम XML में अमान्य होते हैं, जब तक कि document type उन्हें परिभाषित न करे। इसलिए संख्यात्मक कैरेक्टर रेफ़रेंस अक्सर अधिक सुरक्षित विकल्प होते हैं।
क्या एंटिटी कन्वर्टर खराब HTML को ठीक कर देगा?
नहीं। यह एंटिटी रेफ़रेंस को कन्वर्ट कर सकता है, लेकिन टैग को संतुलित नहीं करता, गलत nesting नहीं सुधारता और दस्तावेज़ को validate नहीं करता। कन्वर्ज़न के बाद आसपास के मार्कअप की जांच करें। अगर पेज अब भी उम्मीद के मुताबिक काम न करे, तो HTML validator का इस्तेमाल करें।
आखिरी जांच
पुष्टि करें कि स्रोत में HTML के नाम वाले या संख्यात्मक कैरेक्टर रेफ़रेंस इस्तेमाल हुए हैं। केवल ज़रूरी कैरेक्टर-रेफ़रेंस परत को कन्वर्ट करें और नतीजे की तुलना उस टेक्स्ट से करें जो वास्तव में दिखाई देना चाहिए। डिकोड की गई सामग्री को लाइव पेज में रखने से पहले उससे बने angle brackets, quotation marks और ampersands को उनके वास्तविक HTML संदर्भ में जांचें।
लोकप्रिय उपकरण
हमारे हस्ताक्षर जनरेटर टूल के साथ अपनी खुद की कस्टम हस्ताक्षर बनाएं और आसानी से डाउनलोड करें।
हमारे टेक्स्ट साइज कैलकुलेटर टूल का उपयोग करके किसी भी टेक्स्ट का आकार बाइट्स (B), किलोबाइट्स (KB), या मेगाबाइट्स (MB) में गणना करें।
रिवर्स IP लुकअप टूल का उपयोग करके किसी भी IP पते से जुड़े डोमेन या होस्ट को जल्दी और आसानी से खोजें।
हमारे पिंग टूल का उपयोग करके किसी भी वेबसाइट, सर्वर, या पोर्ट की स्थिति और प्रतिक्रिया समय को जल्दी और कुशलता से जांचें।
डिजिली लिंक का आईपी लुकअप टूल किसी भी आईपी पते के बारे में विस्तृत जानकारी प्रदान करता है। इस मुफ्त ऑनलाइन सेवा का उपयोग करके व्यापक आईपी डेटा प्राप्त करें।
हमारे WhatsApp लिंक जनरेटर से तुरंत अपना मुफ्त WhatsApp लिंक बनाएं। एक कस्टम संदेश जोड़ें और एक क्लिक में चैट शुरू करें, लॉग इन या कोडिंग की आवश्यकता नहीं।