Calculateur de taille de texte
| Taille |
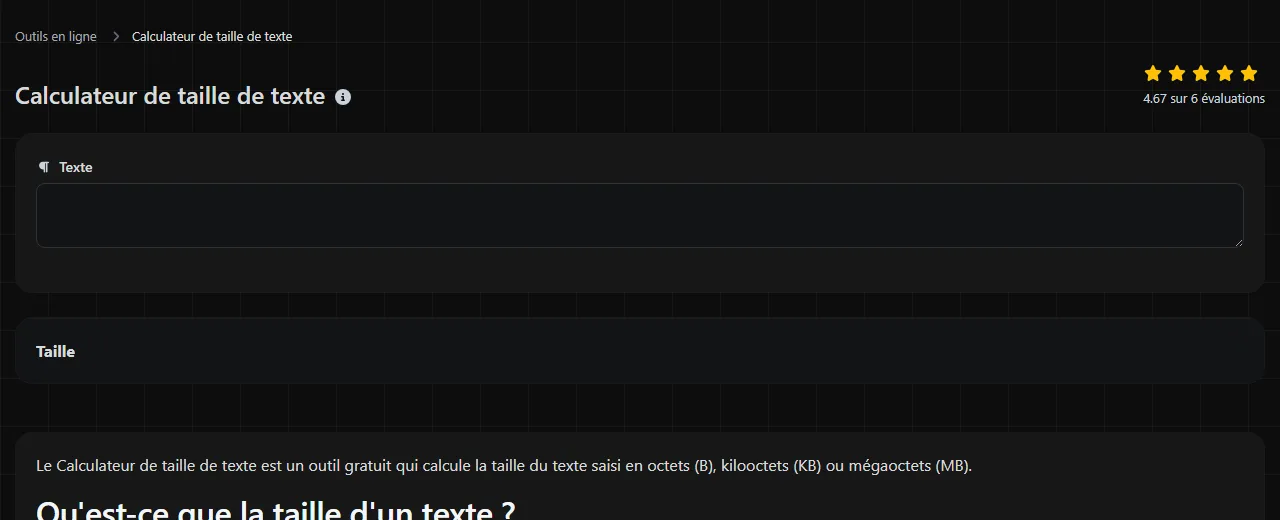
Le Calculateur de taille de texte est un outil gratuit qui calcule la taille du texte saisi en octets (B), kilooctets (KB) ou mégaoctets (MB).
Qu'est-ce que la taille d'un texte ?
La taille d'un texte correspond à l'espace de stockage nécessaire pour représenter une chaîne de caractères. Elle ne doit pas être confondue avec le nombre de caractères, car certains caractères nécessitent plusieurs octets selon l'encodage utilisé.
Par exemple, avec l'encodage UTF-8 :
- A occupe 1 octet.
- £ occupe 2 octets.
- café occupe 5 octets, car le caractère accentué nécessite 2 octets.
- Un emoji courant comme 😀 occupe 4 octets.
Il s'agit d'exemples en UTF-8, et non de résultats garantis par cet outil. Sa description ne précise ni l'encodage de caractères utilisé, ni si un kilooctet correspond à 1 000 ou à 1 024 octets. Cette différence peut avoir son importance à l'approche d'une limite technique.
Comment calculer la taille d'un texte ?
Saisis le texte, puis consulte la valeur affichée dans le champ de résultat Taille.
- Copie ou saisis le texte exact dont tu veux mesurer la taille encodée en octets.
- Vérifie sa taille en octets, en kilooctets ou en mégaoctets.
- Compare le résultat à la limite imposée par le système destinataire.
Inclus la ponctuation, les espaces et les sauts de ligne s'ils figurent dans le texte final. Mieux vaut calculer la version définitive plutôt qu'un premier brouillon. Les caractères d'échappement, les libellés ajoutés et même un saut de ligne final peuvent modifier la taille transmise.
Dans quels cas la vérification de la taille fait-elle gagner du temps ?
Vérifier la taille d'un texte est utile lorsqu'un service limite les données en octets plutôt qu'en caractères visibles. Cela peut éviter des échecs répétés lors de l'importation ou de la validation d'un texte qui semble assez court, mais contient des lettres accentuées, des systèmes d'écriture non latins ou des emoji.
- Requêtes API : vérifie une charge utile JSON ou XML complète avant de l'envoyer par l'intermédiaire d'une passerelle API qui limite la taille du corps.
- Imports dans une base de données : contrôle les valeurs copiées depuis Microsoft Excel ou un fichier CSV avant de les charger dans des champs de base de données limités en octets.
- Préparation d'un publipostage : vérifie les longs paragraphes personnalisés après avoir remplacé les champs réservés par les données des destinataires.
- Champs de CMS : mesure le code intégré, les métadonnées ou le texte structuré avant de les coller dans WordPress ou un autre système de gestion de contenu.
- Systèmes de journaux et de messages : confirme qu'un message généré reste inférieur à la limite d'octets autorisée par entrée.
Pour les exports de feuilles de calcul, mesure le texte nettoyé plutôt que le classeur entier. Les fichiers CSV ajoutent une structure composée de séparateurs et de fins de ligne, et peuvent contenir une marque d'encodage. Les fichiers XLSX incluent aussi la structure et les métadonnées du classeur. Le résultat obtenu pour le texte ne correspondra donc pas forcément à la taille affichée pour un fichier XLSX ou CSV.
Pourquoi le nombre d'octets diffère-t-il du nombre de caractères ?
Le nombre d'octets est différent parce que les encodages stockent les caractères avec un nombre variable d'octets. En UTF-8, les lettres latines de base et les chiffres occupent généralement un octet, tandis que de nombreux caractères accentués, symboles et systèmes d'écriture en nécessitent davantage.
Les espaces et les signes de ponctuation occupent eux aussi de l'espace. Les fins de ligne provoquent souvent de petits écarts. Les systèmes de type Unix utilisent généralement un seul caractère de saut de ligne, tandis que les fichiers texte Windows associent couramment un retour chariot à un saut de ligne. Un même texte multiligne visible peut donc avoir une taille différente une fois enregistré.
Pour vérifier les limites de caractères sur des plateformes comme X ou LinkedIn, la taille en octets ne suffit pas. Ces services appliquent des règles de comptage ou de pondération des caractères au lieu d'utiliser le total d'octets UTF-8 comme limite de publication. De même, ce calcul ne tient compte ni de la mise en forme du document, ni des images, ni des en-têtes de fichier, ni de la compression.
Questions fréquentes
Puis-je coller un texte confidentiel dans le calculateur ?
On ne sait pas avec certitude où cet outil traite le texte saisi.
La mise en forme copiée modifie-t-elle le résultat ?
Le résultat porte sur le texte saisi dans l'outil, et non sur la taille totale d'un document Word, d'un e-mail ou d'une page web. Les polices, les couleurs, le suivi des modifications, les images intégrées et d'autres données du document peuvent occuper de l'espace sans apparaître comme du texte ordinaire.
Puis-je utiliser le résultat pour une requête JSON ?
Oui, mais calcule la taille du JSON final sérialisé plutôt que celle d'une valeur isolée. Les guillemets, les noms de propriétés, les virgules, les crochets et les caractères d'échappement ajoutent tous des octets. Les en-têtes HTTP et l'encodage de transport peuvent également ajouter des données en dehors du corps de la requête.
L'outil peut-il calculer le nombre de SMS nécessaires ?
Non, un simple nombre d'octets ne suffit pas à prévoir le découpage d'un SMS. Les SMS utilisent couramment l'alphabet GSM 7 bits par défaut ou l'encodage UCS-2, et les messages en plusieurs parties réservent de l'espace aux informations qui servent à les relier. Certains caractères, comme les guillemets typographiques, peuvent modifier l'encodage utilisé pour l'ensemble du message. La prise en charge des emoji peut quant à elle dépendre de l'utilisation d'UTF-16 par l'opérateur ou d'une autre méthode de traitement non standard.
Les caractères invisibles comptent-ils dans la taille du texte ?
Oui, c'est possible. Les tabulations, les sauts de ligne, les espaces insécables, les caractères de largeur nulle et une marque d'ordre des octets peuvent occuper de l'espace, même s'ils sont difficiles, voire impossibles, à voir. Si le résultat est anormalement élevé, colle le contenu dans un éditeur ou un mode d'inspection qui affiche les caractères invisibles ou les points de code, puis relance le calcul.
Dernières vérifications
Utilise le texte exact que recevra le système destinataire, y compris les sauts de ligne et les caractères d'échappement. Si tu dois d'abord nettoyer du contenu copié depuis le web, le Suppresseur de balises HTML peut retirer le balisage avant le calcul. Pour respecter des limites strictes d'API, de base de données ou de fichier, vérifie dans la documentation du système l'encodage requis et la définition de l'unité utilisée.
Outils populaires
Créez votre propre signature personnalisée et téléchargez-la facilement avec notre outil de génération de signatures pour des signatures électroniques personnalisées.
Calculez la taille de n'importe quel texte en octets (B), kilooctets (KB) ou mégaoctets (MB) à l'aide de notre outil de calcul de taille de texte.
Utilisez l'outil de recherche inversée d'IP pour trouver rapidement et facilement le domaine ou l'hôte associé à une adresse IP.
Utilisez notre outil de ping pour vérifier rapidement et efficacement le statut et le temps de réponse de n'importe quel site web, serveur ou port.
L'outil de recherche d'IP de Digily Link fournit des informations détaillées sur toute adresse IP. Utilisez ce service en ligne gratuit pour obtenir des données IP complètes.
Générez instantanément votre lien WhatsApp gratuit avec notre générateur de liens WhatsApp. Ajoutez un message personnalisé et lancez des discussions en un clic, sans connexion ni code.