Analyseur d'URL
Extrayez des informations détaillées de n'importe quelle URL avec notre analyseur d'URL afin d'analyser précisément les adresses web.
L'Analyseur d'URL est un outil gratuit qui décompose une adresse web en schéma, chemin et chaîne de requête.
Quelles informations l'analyseur extrait-il d'une URL ?
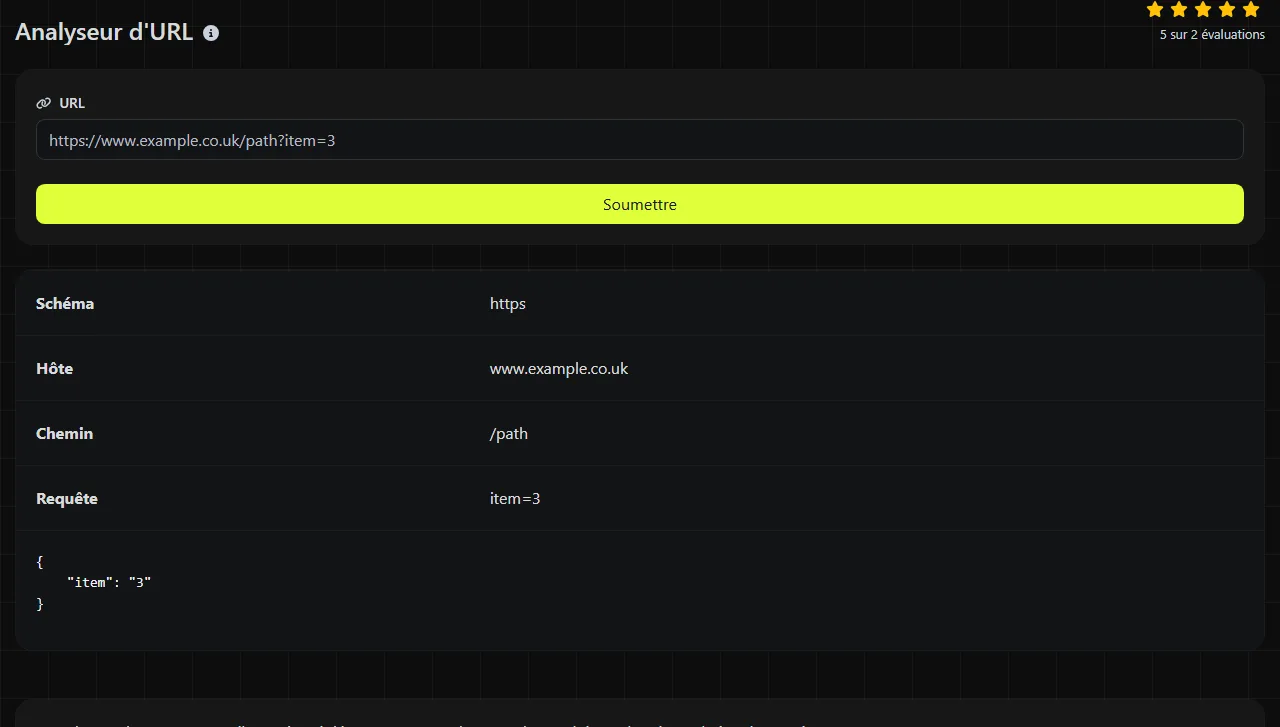
Un analyseur d'URL identifie les différents éléments d'une adresse web sans t'obliger à séparer le texte manuellement. Cet outil renvoie trois champs produits par la fonction parse_url de PHP.
- Schéma indique le protocole ou le schéma d'adressage, par exemple https ou http.
- Chemin indique le chemin, par exemple /account/orders/42.
- Requête contient le texte situé après le point d'interrogation qui marque le début de la requête et avant tout croisillon non encodé, par exemple page=2&sort=date.
L'analyse est utile pour examiner des requêtes d'API, des URL de rappel, des journaux d'application ou des données provenant de services tiers. Elle permet de distinguer les informations de routage des paramètres de requête avant de déboguer, de journaliser ou de transformer l'adresse.
Les champs renvoyés ne comprennent pas séparément le nom d'hôte, le port ou le fragment. Si tu as besoin de ces éléments, utilise une bibliothèque d'analyse d'URL plus complète dans ton application.
Comment utiliser l'Analyseur d'URL ?
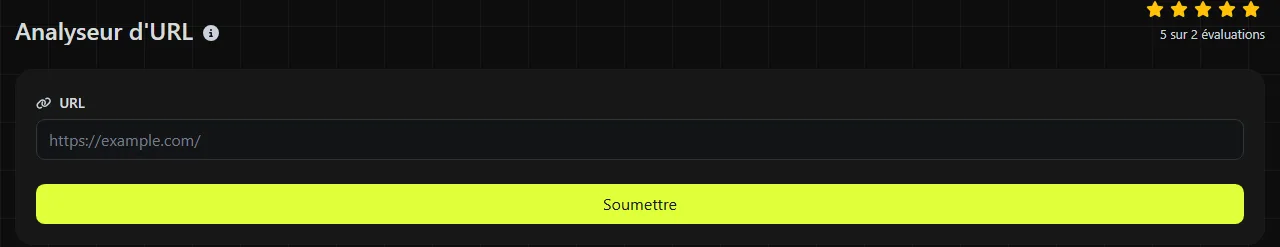
Saisis une URL complète ou partielle, puis examine les valeurs de schéma, de chemin et de requête renvoyées par l'outil. Une URL absolue complète donne généralement le résultat le plus clair, car elle indique explicitement le schéma.
- Copie l'URL depuis le navigateur, une réponse d'API, un enregistrement de webhook ou un journal de serveur.
- Inclus la chaîne de requête si tu dois examiner les noms ou les valeurs des paramètres.
- Compare le chemin renvoyé à la route attendue par ton application.
- Vérifie que le schéma et la requête sont présents si ton intégration les exige.
Le traitement s'effectue sur le serveur. Ta saisie est transmise au serveur via HTTPS et n'est pas stockée. Malgré cela, évite d'envoyer des jetons d'accès actifs, des liens de téléchargement signés, des identifiants de session ou d'autres données d'authentification lorsqu'un exemple expurgé suffit pour obtenir la même réponse.
Exemples pratiques et interprétation des résultats
Pour une URL absolue d'API, l'analyseur sépare le protocole, la route et la chaîne de requête brute.
Entrée https://api.example.co.uk/v1/orders/42?expand=items¤cy=GBP
Schéma https
Chemin /v1/orders/42
Requête expand=items¤cy=GBP
La requête est renvoyée comme un seul élément. Selon la convention courante des formulaires et des chaînes de requête, l'esperluette sépare les champs, tandis que le premier signe égal de chaque champ sépare son nom de sa valeur. L'analyse de l'URL ne confirme pas à elle seule que expand ou currency est un paramètre reconnu par l'API.
Une référence relative peut également contenir un chemin et une requête sans préciser de schéma.
Entrée /search?q=red%20shoes&page=2
Schéma no scheme component
Chemin /search
Requête q=red%20shoes&page=2
L'absence de schéma est souvent normale pour les liens générés au sein d'un même site. En revanche, dans des données censées contenir des URL de rappel absolues, le même résultat peut révéler l'absence du préfixe https://.
Cet analyseur ne valide pas les URL. Il peut aider à repérer une structure suspecte, comme un schéma manquant, un chemin inattendu ou du texte de requête mal placé. Toutefois, un résultat analysé ne prouve pas que l'adresse existe, qu'elle est résolue dans le DNS ou qu'elle renvoie une réponse HTTP réussie.
Que se passe-t-il avec les espaces, la ponctuation et les saisies inhabituelles ?
Les caractères réservés influencent la façon dont une URL est découpée, tandis que les caractères encodés restent généralement dans l'élément auquel ils appartiennent. L'analyseur sépare les éléments sans décoder ni normaliser leur contenu.
- Un point d'interrogation non encodé marque le début de la requête. Si un point d'interrogation littéral doit servir de donnée en dehors d'une requête existante, il faut l'encoder en pourcentage lorsqu'il risquerait autrement d'être interprété comme le séparateur de requête.
- Une esperluette sépare généralement les paramètres de requête, mais cet outil renvoie la chaîne de requête complète plutôt qu'une interprétation paramètre par paramètre.
- Un croisillon non encodé (#) délimite le fragment dans la syntaxe standard des URL. Les données du fragment ne font pas partie des champs renvoyés ici.
- Les espaces doivent normalement être encodés, le plus souvent sous la forme %20. Un signe plus peut représenter un espace dans les données de requête encodées comme un formulaire, mais cette interprétation relève du décodage de la requête, pas de l'analyse de l'URL.
- Les caractères accentués et non latins présents dans un chemin ou une requête doivent utiliser l'encodage en pourcentage UTF-8 lorsque le système destinataire l'exige. Les noms de domaine internationalisés utilisent leur forme compatible ASCII afin d'assurer une large compatibilité avec les protocoles.
- Les chiffres ne font l'objet d'aucun traitement particulier. Ils restent des caractères ordinaires dans un chemin ou une valeur de requête.
Une saisie vide ne contient aucune structure d'URL utile à examiner. Les URL très longues peuvent également se heurter à des limites imposées ailleurs, notamment par les navigateurs, les serveurs web, les proxys et les frameworks d'application. Cet outil ne permet pas de déterminer si un autre système acceptera une URL d'une longueur donnée.
Dans quels cas est-il utile d'analyser une URL ?
Analyser une URL est utile lorsque tu dois comprendre la structure d'une adresse avant qu'un programme ou une infrastructure ne l'utilise. Tu peux notamment vérifier des adresses de rappel de webhook avant leur déploiement, examiner des cibles de redirection, séparer les routes d'API des filtres ou lire des URL copiées depuis les journaux d'un proxy inverse.
Cette opération est généralement inutile si seule une machine doit traiter une URL connue et déjà structurée, et que ton application utilise déjà une bibliothèque dédiée. Ce n'est pas non plus la bonne méthode si tu dois tester la disponibilité d'une adresse, suivre les redirections, décoder chaque paramètre de requête ou vérifier qu'un domaine est digne de confiance.
Pour des traitements répétés ou automatisés, utilise les fonctions de gestion des URL intégrées à ton environnement. PHP propose parse_url, le JavaScript des navigateurs dispose de l'interface URL, Node.js fournit la classe URL et Python inclut urllib.parse. Pour traiter un fichier journal contenant des milliers d'adresses, un petit script en ligne de commande est plus adapté qu'une analyse manuelle.
N'analyse pas une URL dans le seul but de la reformater si elle possède déjà exactement la représentation exigée par le système destinataire. Réencoder ou reconstruire des adresses sans raison précise peut modifier les signatures de requête, les paramètres en double ou les caractères réservés.
Questions fréquentes
Peut-on analyser une URL sans http ni https ?
Oui. La fonction parse_url de PHP peut interpréter des références relatives et des URL partielles, mais aucun schéma ne sera disponible s'il n'a pas été fourni. Fais attention aux adresses relatives au schéma qui commencent par deux barres obliques, car leur signification dépend du document ou de l'application qui les utilise.
Les paramètres de requête répétés sont-ils conservés ?
La requête est renvoyée sous sa forme brute. Les noms répétés peuvent donc rester présents dans leur ordre d'origine. La conversion de valeurs comme tag=red&tag=blue en tableaux ou en valeurs distinctes dépend de l'analyseur de chaîne de requête utilisé ensuite.
Est-il sûr de coller une URL signée ?
La saisie est envoyée via HTTPS et n'est pas stockée, mais une URL signée peut tout de même donner accès à du contenu privé tant que sa signature reste valide. Masque le jeton ou remplace le nom d'hôte et les valeurs par des données fictives représentatives lorsque les identifiants exacts ne sont pas nécessaires.
Pourquoi une URL qui semble valide se comporte-t-elle différemment dans mon application ?
Ces différences peuvent venir du décodage des requêtes propre au framework ou de la normalisation Unicode. Les applications peuvent aussi appliquer des règles supplémentaires après l'analyse, notamment des listes de noms d'hôte autorisés et des restrictions de redirection. Compare l'URL brute octet par octet, puis vérifie ce que ton application décode ou réécrit avant d'envoyer la requête.
Outils populaires
Créez votre propre signature personnalisée et téléchargez-la facilement avec notre outil de génération de signatures pour des signatures électroniques personnalisées.
Calculez la taille de n'importe quel texte en octets (B), kilooctets (KB) ou mégaoctets (MB) à l'aide de notre outil de calcul de taille de texte.
Utilisez l'outil de recherche inversée d'IP pour trouver rapidement et facilement le domaine ou l'hôte associé à une adresse IP.
Utilisez notre outil de ping pour vérifier rapidement et efficacement le statut et le temps de réponse de n'importe quel site web, serveur ou port.
L'outil de recherche d'IP de Digily Link fournit des informations détaillées sur toute adresse IP. Utilisez ce service en ligne gratuit pour obtenir des données IP complètes.
Générez instantanément votre lien WhatsApp gratuit avec notre générateur de liens WhatsApp. Ajoutez un message personnalisé et lancez des discussions en un clic, sans connexion ni code.