URL-parser
Extraheer gedetailleerde informatie van elke URL met onze URL-parser tool voor nauwkeurige webadresanalyse.
De URL-parser is een gratis tool die een webadres opsplitst in het schema, het pad en de querystring.
Welke onderdelen haalt een URL-parser uit een adres?
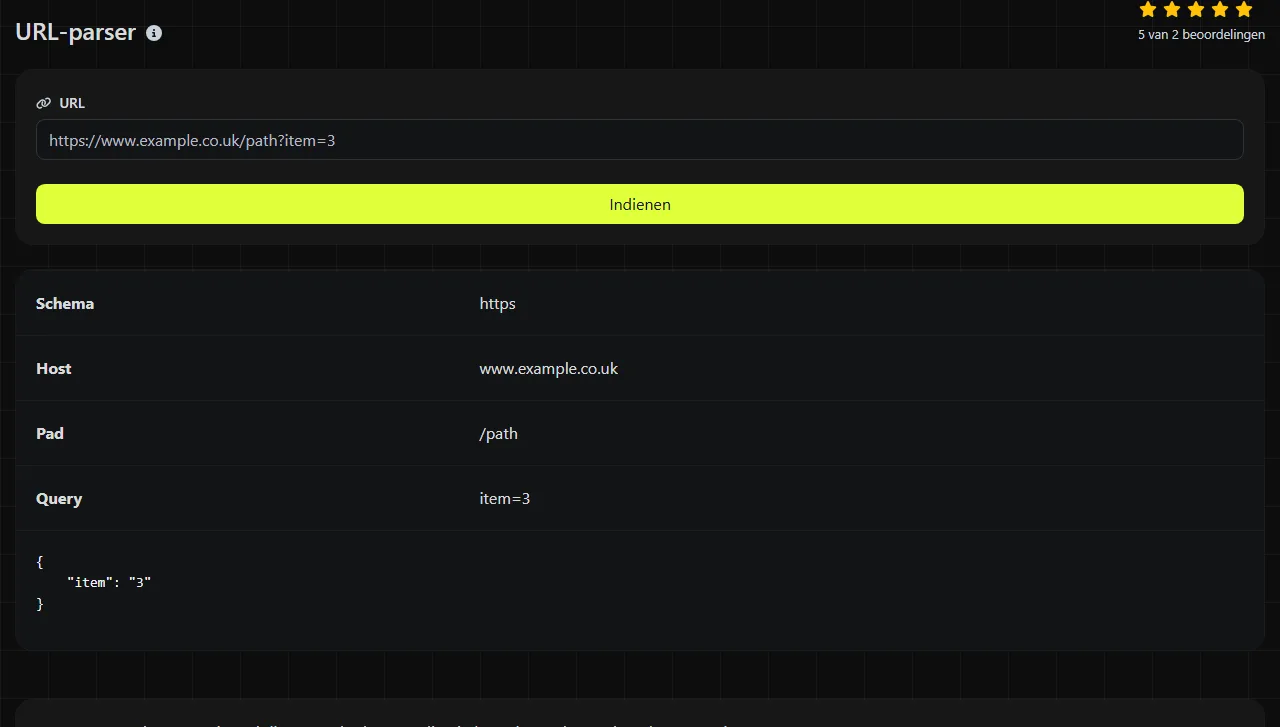
Een URL-parser herkent de structurele onderdelen van een webadres, zodat je de tekst niet handmatig hoeft op te splitsen. Deze tool geeft drie velden terug via de PHP-functie parse_url.
- Schema geeft het protocol of adresseringsschema aan, zoals HTTPS of HTTP.
- Pad geeft het pad aan, zoals /account/orders/42.
- Query bevat de tekst na het vraagteken waarmee de query begint en vóór een niet-gecodeerd hekje, zoals page=2&sort=date.
Parsen is handig bij het controleren van API-verzoeken, callback-URL's, applicatielogs of gegevens van derden. Zo kun je routeringsinformatie onderscheiden van queryparameters voordat je fouten opspoort, gegevens logt of het adres bewerkt.
De uitvoer bevat geen afzonderlijke hostnaam, poort of fragment. Heb je die onderdelen nodig, gebruik dan een uitgebreidere bibliotheek voor het parsen van URL's in je applicatie.
Hoe gebruik ik de URL-parser?
Voer een volledige of gedeeltelijke URL in en bekijk het schema, het pad en de query die de tool teruggeeft. Een volledige absolute URL levert meestal het duidelijkste resultaat op, omdat het schema daarin expliciet staat.
- Kopieer de URL uit de browser, een API-respons, een webhookregistratie of een serverlog.
- Neem de querystring mee als je de namen of waarden van parameters wilt controleren.
- Vergelijk het gevonden pad met de route die je applicatie verwacht.
- Controleer of het schema en de query aanwezig zijn als je integratie die vereist.
De verwerking vindt plaats op de server. Je invoer wordt via HTTPS naar de server verzonden en niet opgeslagen. Vermijd desondanks actieve toegangstokens, ondertekende downloadlinks, sessie-ID's en andere inloggegevens als een geanonimiseerd voorbeeld voldoende is.
Voorbeelden en uitleg van de resultaten
Bij een absolute API-URL scheidt de parser het protocol van de route en de onbewerkte querystring.
Invoer https://api.example.co.uk/v1/orders/42?expand=items¤cy=GBP
Schema https
Pad /v1/orders/42
Query expand=items¤cy=GBP
De query wordt als één onderdeel teruggegeven. Volgens de gebruikelijke conventie voor formulieren en querystrings scheidt het ampersandteken de velden, terwijl het eerste isgelijkteken in elk veld de naam van de waarde scheidt. Alleen het parsen van de URL bevestigt niet dat expand of currency een door de API herkende parameter is.
Een relatieve verwijzing kan ook een pad en query bevatten zonder een schema op te geven.
Invoer /search?q=red%20shoes&page=2
Schema geen schemaonderdeel
Pad /search
Query q=red%20shoes&page=2
Bij links die binnen één website zijn gegenereerd, is een ontbrekend schema vaak normaal. In gegevens die absolute callback-URL's horen te bevatten, kan hetzelfde resultaat echter wijzen op een ontbrekend voorvoegsel https://.
Deze parser is geen URL-validator. De tool kan verdachte structuren zichtbaar maken, zoals een ontbrekend schema, een onverwacht pad of querytekst op de verkeerde plaats. Een geparset resultaat bewijst echter niet dat het adres bestaat, via DNS kan worden gevonden of een geslaagde HTTP-respons oplevert.
Wat gebeurt er met spaties, leestekens en ongebruikelijke invoer?
Gereserveerde tekens bepalen mede hoe een URL wordt opgesplitst. Gecodeerde tekens blijven doorgaans onderdeel van de component waarin ze staan. De parser scheidt de componenten, maar decodeert of normaliseert de inhoud ervan niet.
- Een niet-gecodeerd vraagteken markeert het begin van de query. Een letterlijk vraagteken dat buiten een bestaande query als gegeven is bedoeld, moet procentgecodeerd worden als het anders als scheidingsteken voor de query zou werken.
- Een ampersandteken scheidt vaak queryparameters, maar deze tool geeft de volledige querystring terug en verwerkt de parameters niet afzonderlijk.
- Een niet-gecodeerd hekje (#) is in de standaardsyntaxis van URL's het scheidingsteken voor een fragment. Fragmentgegevens behoren niet tot de velden die deze tool teruggeeft.
- Spaties moeten normaal gesproken worden gecodeerd, meestal als %20. Een plusteken kan in formuliergecodeerde querygegevens voor een spatie staan, maar die interpretatie hoort bij het decoderen van de query en niet bij het parsen van de URL.
- Tekst met accenten of niet-Latijnse tekens in een pad of query moet waar nodig voor het ontvangende systeem met UTF-8-procentcodering worden gecodeerd. Geïnternationaliseerde domeinnamen gebruiken hun ASCII-compatibele vorm voor brede compatibiliteit met protocollen.
- Getallen worden niet op een bijzondere manier verwerkt. Ze blijven gewone tekens binnen een pad of querywaarde.
Lege invoer bevat geen bruikbare URL-structuur om te controleren. Zeer lange URL's kunnen daarnaast tegen limieten van andere systemen aanlopen, waaronder browsers, webservers, proxy's en applicatieframeworks. Deze tool stelt niet vast of een ander systeem een URL met een bepaalde lengte accepteert.
Wanneer is het nuttig om een URL te parsen?
Een URL parsen is nuttig als je wilt onderzoeken hoe een adres is opgebouwd voordat code of infrastructuur het verwerkt. Denk aan het controleren van callback-adressen voor webhooks vóór implementatie, het beoordelen van omleidingsdoelen, het scheiden van API-routes en filters, of het lezen van URL's uit logs van reverse proxy's.
Parsen is meestal niet nodig als alleen een machine een bekende, al gestructureerde URL verwerkt en je applicatie al een URL-bibliotheek gebruikt. Het is ook niet de juiste bewerking als je de beschikbaarheid wilt testen, omleidingen wilt volgen, elke queryparameter wilt decoderen of de betrouwbaarheid van een domein wilt verifiëren.
Gebruik voor herhaald of geautomatiseerd werk de ingebouwde URL-functies van je omgeving. PHP heeft parse_url, JavaScript in de browser heeft de URL-interface, Node.js biedt de klasse URL en Python bevat urllib.parse. Voor een logbestand met duizenden adressen is een klein opdrachtregelscript geschikter dan handmatig parsen.
Parse een URL niet alleen om die opnieuw op te maken als deze al exact de notatie heeft die het ontvangende systeem vereist. Adressen zonder duidelijke reden opnieuw coderen of opbouwen kan queryhandtekeningen, dubbele parameters of gereserveerde tekens wijzigen.
Veelgestelde vragen
Kan ik een URL zonder http of https parsen?
Ja, de PHP-functie parse_url kan relatieve verwijzingen en gedeeltelijke URL's interpreteren. Als er geen schema is opgegeven, is er alleen geen schema beschikbaar. Wees voorzichtig met schemarelatieve adressen die met twee schuine strepen beginnen, want hun betekenis hangt af van het omringende document of de applicatie.
Blijven herhaalde queryparameters behouden?
De query wordt als onbewerkt onderdeel teruggegeven, waardoor herhaalde namen in hun oorspronkelijke volgorde aanwezig kunnen blijven. Hoe waarden zoals tag=red&tag=blue daarna worden omgezet in arrays of afzonderlijke waarden, hangt af van de gebruikte querystringparser.
Kan ik veilig een ondertekende URL plakken?
De invoer wordt via HTTPS verzonden en niet opgeslagen, maar een ondertekende URL kan toegang tot privé-inhoud geven zolang de handtekening geldig is. Maak het token onherkenbaar of vervang de hostnaam en waarden door representatieve tijdelijke waarden als de exacte inloggegevens niet nodig zijn.
Waarom werkt een geldig ogende URL anders in mijn applicatie?
Verschillen kunnen ontstaan door frameworkspecifieke decodering van query's en Unicode-normalisatie. Applicaties kunnen na het parsen ook aanvullende regels toepassen, waaronder lijsten met toegestane hostnamen en beperkingen voor omleidingen. Vergelijk de onbewerkte URL byte voor byte en controleer vervolgens wat je applicatie decodeert of herschrijft voordat het verzoek wordt verzonden.
Populaire tools
Maak je eigen aangepaste handtekening en download deze eenvoudig met onze handtekeninggenerator voor gepersonaliseerde e-handtekeningen.
Bereken de grootte van elke tekst in Bytes (B), Kilobytes (KB) of Megabytes (MB) met behulp van onze tekstgrootte-calculator.
Gebruik de reverse IP lookup tool om snel en eenvoudig het domein of de host te vinden die aan een IP-adres is gekoppeld.
Gebruik onze ping-tool om de status en responstijd van elke website, server of poort snel en efficiënt te controleren.
De IP-opzoektool van Digily Link biedt gedetailleerde informatie over elk IP-adres. Gebruik deze gratis online service om uitgebreide IP-gegevens te verkrijgen.
Genereer direct je gratis WhatsApp-link met onze WhatsApp Link Generator. Voeg een aangepast bericht toe en start chats met één klik. Geen login of codering vereist.