URLパーサー
URLパーサーツールを使用して、あらゆるURLから詳細情報を抽出し、正確なウェブアドレス分析を行います。
URLパーサーは、Webアドレスをスキーム、パス、クエリ文字列に分ける無料ツールです。
URLパーサーで何を抽出できますか?
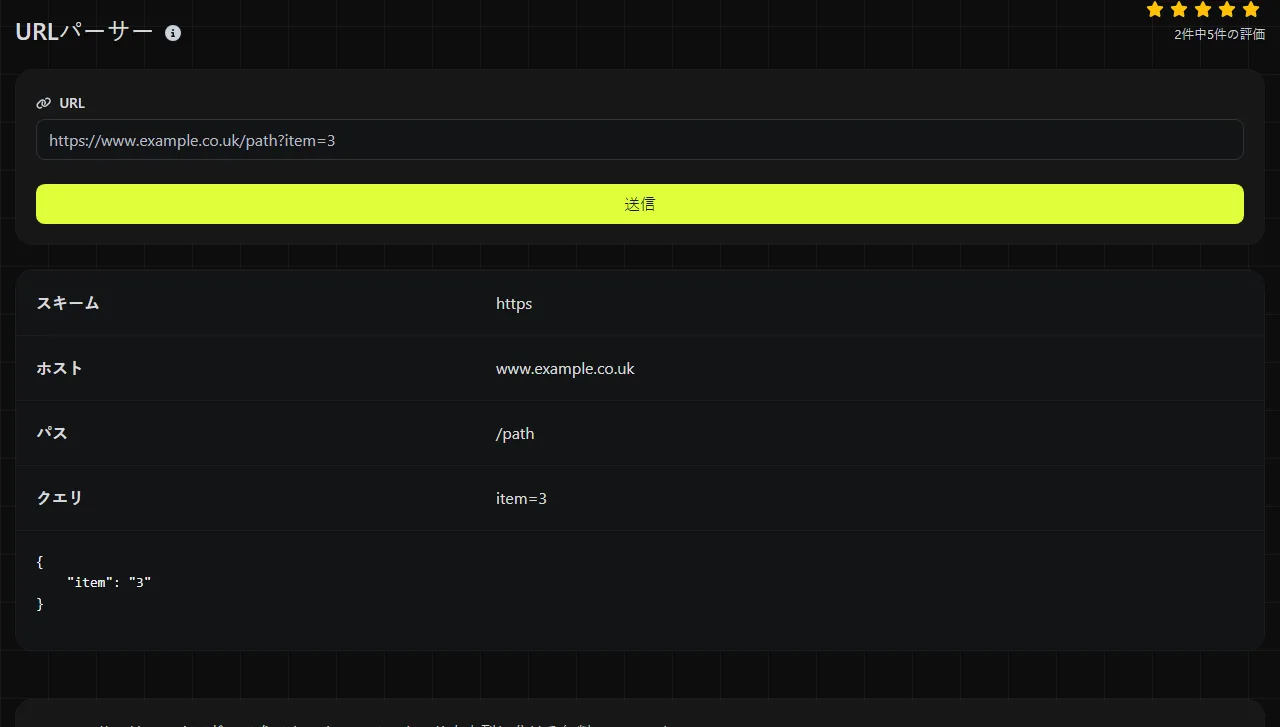
URLパーサーを使うと、Webアドレスを手作業で分割せずに、その構成要素を特定できます。このツールは、PHPのparse_url関数で得られた3つのフィールドを返します。
- スキームは、httpsやhttpなどのプロトコルまたはアドレス指定方式を示します。
- パスは、/account/orders/42などのパス部分を示します。
- クエリには、クエリ部分の開始を示す疑問符より後、かつパーセントエンコードされていない番号記号より前のテキストが入ります。たとえばpage=2&sort=dateです。
URLの解析は、APIリクエスト、コールバックURL、アプリケーションログ、第三者から受け取ったデータを調べるときに役立ちます。アドレスのデバッグ、記録、変換を行う前に、ルーティング情報とクエリパラメータを切り分けられます。
返されるフィールドに、ホスト名、ポート、フラグメントは個別に含まれません。これらの要素が必要な場合は、アプリケーションでより高機能なURL解析ライブラリを使用してください。
URLパーサーの使い方は?
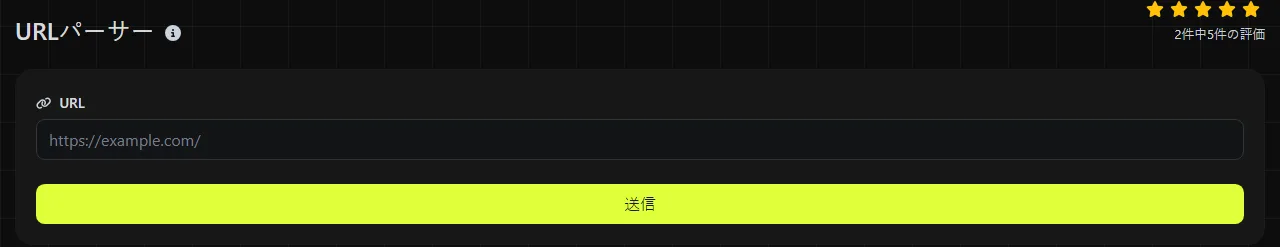
完全なURLまたはURLの一部を入力し、ツールが返すスキーム、パス、クエリの値を確認します。通常は、スキームが明示された完全な絶対URLを入力すると、最も分かりやすい結果を得られます。
- ブラウザ、APIレスポンス、Webhookの記録、サーバーログのいずれかからURLをコピーします。
- パラメータ名や値を確認する場合は、クエリ文字列も含めます。
- 返されたパスを、アプリケーションが想定するルートと比較します。
- 連携処理で必要なスキームとクエリが含まれているか確認します。
処理はサーバー上で行われます。入力内容はHTTPS経由でサーバーに送信され、保存されません。それでも、伏せ字にした例で同じ確認ができる場合は、有効なアクセストークン、署名付きダウンロードリンク、セッション識別子、その他の認証情報を送信しないでください。
実例と結果の読み方
絶対形式のAPI URLを入力すると、パーサーはプロトコル、ルート、未加工のクエリ文字列を分離します。
入力 https://api.example.co.uk/v1/orders/42?expand=items¤cy=GBP
スキーム https
パス /v1/orders/42
クエリ expand=items¤cy=GBP
クエリは1つの構成要素として返されます。一般的なフォームおよびクエリ文字列の規則では、アンパサンドが各フィールドを区切り、それぞれのフィールドで最初に現れる等号が名前と値を区切ります。ただし、URLを解析しただけでは、expandやcurrencyがAPIで認識されるパラメータかどうかは確認できません。
相対参照には、スキームを指定せずにパスとクエリを含めることもできます。
入力 /search?q=red%20shoes&page=2
スキーム no scheme component
パス /search
クエリ q=red%20shoes&page=2
同じWebサイト内で生成されるリンクなら、スキームがないのはよくあることです。一方、絶対形式のコールバックURLが入るはずのデータでは、同じ結果がhttps://プレフィックスの欠落を示している可能性があります。
このパーサーはURL検証ツールではありません。スキームの欠落、想定外のパス、不適切な位置にあるクエリテキストなど、不審な構造を見つける手掛かりにはなります。ただし、解析できたからといって、そのアドレスが実在する、DNSで名前解決できる、またはHTTPリクエストに成功するとは限りません。
空白、記号、特殊な入力はどう扱われますか?
予約文字はURLの分割方法に影響します。一方、エンコードされた文字は通常、その文字が現れる構成要素の一部として維持されます。パーサーが行うのは構成要素の分離であり、内容のデコードや正規化ではありません。
- パーセントエンコードされていない疑問符は、クエリ部分の開始を示します。既存のクエリ外で疑問符そのものをデータとして扱いたい場合、クエリの区切りと解釈される可能性があるなら、パーセントエンコードしてください。
- アンパサンドは一般にクエリパラメータの区切りとして使われますが、このツールはパラメータを個別に解釈せず、クエリ文字列全体を返します。
- 標準的なURL構文では、パーセントエンコードされていない番号記号(#)がフラグメントの区切りです。フラグメントのデータは、このツールが返すフィールドに含まれません。
- 通常、空白はエンコードする必要があり、一般には%20を使用します。フォームエンコードされたクエリデータではプラス記号が空白を表す場合もありますが、これはURL解析ではなくクエリのデコード時に行う解釈です。
- アクセント付き文字や非ラテン文字をパスまたはクエリに含める場合は、受信側システムの要件に応じてUTF-8のパーセントエンコードを使用してください。国際化ドメイン名では、幅広いプロトコルとの互換性を確保するため、ASCII互換形式を使用します。
- 数字に特別な解析動作はありません。パスまたはクエリ値の中で、通常の文字としてそのまま扱われます。
入力が空では、確認できる有用なURL構造がありません。また、非常に長いURLは、ブラウザ、Webサーバー、プロキシ、アプリケーションフレームワークなど、別の場所にある上限に達する可能性があります。このツールでは、特定の長さのURLを他のシステムが受け入れるかどうかは判定できません。
URLを解析したほうがよいのはどんなときですか?
コードやインフラストラクチャがアドレスを処理する前に、その構造を調べたい場合はURL解析が役立ちます。よくある用途として、デプロイ前のWebhookコールバックアドレスの確認、リダイレクト先のチェック、APIルートとフィルターの分離、リバースプロキシのログからコピーしたURLの確認があります。
既知の構造化済みURLを機械だけが処理し、アプリケーションですでにURLライブラリを使用している場合、通常は手動で解析する必要はありません。また、接続可否のテスト、リダイレクトの追跡、全クエリパラメータのデコード、ドメインが信頼できるかどうかの検証が目的なら、URL解析は適切な操作ではありません。
繰り返し処理や自動処理には、実行環境に標準で備わっているURL機能を使用してください。PHPにはparse_url、ブラウザのJavaScriptにはURLインターフェース、Node.jsにはURLクラスがあり、Pythonにはurllib.parseが含まれます。数千件のアドレスを含むログファイルを処理するなら、手作業で解析するよりも小さなコマンドラインスクリプトが適しています。
受信側システムが求める表現とすでに完全に一致しているURLを、単に整形し直す目的で解析しないでください。明確な理由なくアドレスを再エンコードまたは再構築すると、クエリ署名、重複パラメータ、予約文字が変わる可能性があります。
よくある質問
httpやhttpsがないURLも解析できますか?
はい。PHPのparse_url関数は相対参照や部分的なURLも解釈できます。ただし、スキームが指定されていなければ、スキームの値は得られません。2本のスラッシュで始まるスキーム相対URLは、周囲の文書やアプリケーションによって意味が変わるため注意してください。
同じクエリパラメータが複数あっても残りますか?
クエリは未加工の構成要素として返されるため、同じ名前のパラメータは元の順序のまま残ります。tag=red&tag=blueのような値を配列や個別の値に変換する方法は、その後に使用するクエリ文字列パーサーによって異なります。
署名付きURLを貼り付けても安全ですか?
入力はHTTPS経由で送信され、保存されません。ただし、署名付きURLは、その署名が有効な間、非公開コンテンツへのアクセスを許可する可能性があります。正確な認証情報が不要なら、トークンを伏せるか、ホスト名と値を内容の分かるプレースホルダーに置き換えてください。
正しいURLに見えるのに、アプリでは動作が違うのはなぜですか?
フレームワーク固有のクエリデコードやUnicode正規化によって違いが生じることがあります。また、アプリケーションによっては解析後に、許可するホスト名のリストやリダイレクト制限などの追加ルールを適用します。まず未加工のURLをバイト単位で比較し、その後、リクエスト送信前にアプリケーションが何をデコードまたは書き換えているか確認してください。
人気のツール
Digily LinkのIPルックアップツールは、任意のIPアドレスに関する詳細情報を提供します。この無料オンラインサービスを利用して、包括的なIPデータを取得してください。
WhatsAppリンクジェネレーターで無料のWhatsAppリンクを即座に生成します。カスタムメッセージを追加して、ワンクリックでチャットを開始できます。ログインやコーディングは不要です。