URL-Parser
Extrahieren Sie detaillierte Informationen aus jeder URL mit unserem URL-Parser-Tool für eine genaue Webadressenanalyse.
Der URL-Parser ist ein kostenloses Tool, das eine Webadresse in Schema, Pfad und Abfragezeichenfolge zerlegt.
Welche Bestandteile extrahiert ein URL-Parser?
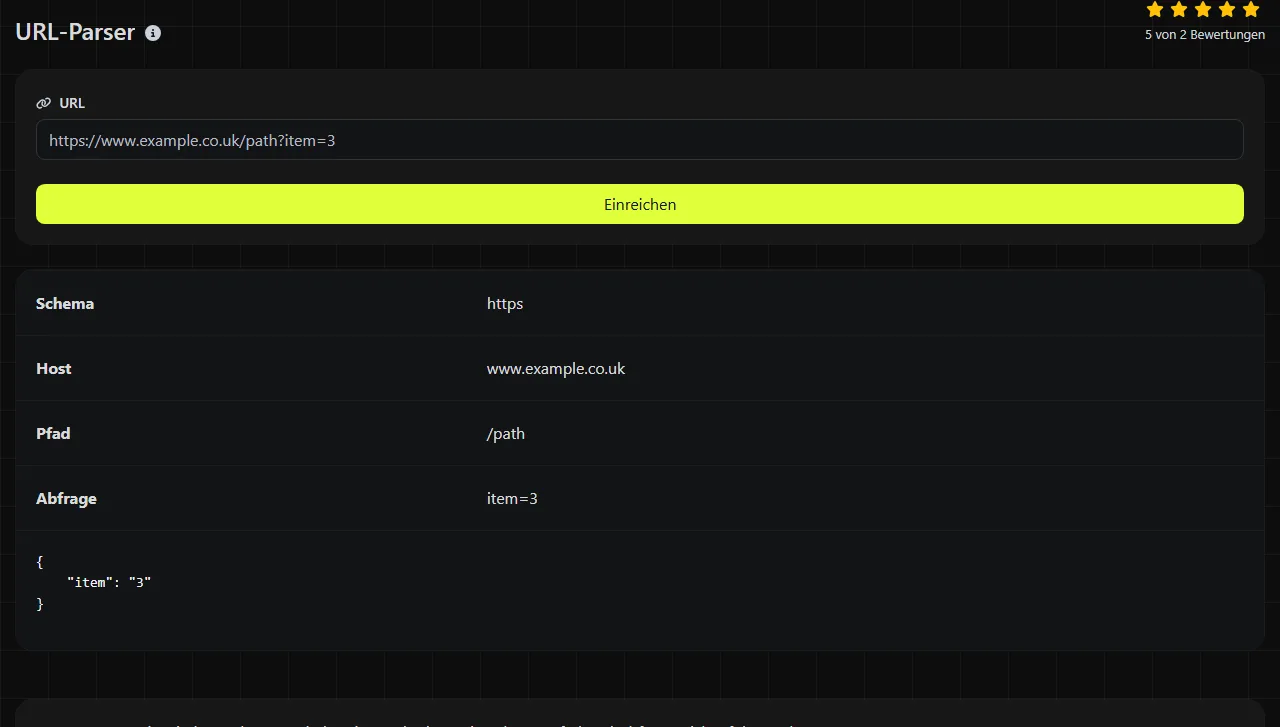
Ein URL-Parser erkennt die strukturellen Bestandteile einer Webadresse, ohne dass du den Text von Hand aufteilen musst. Dieses Tool gibt drei Felder zurück, die mit der PHP-Funktion parse_url ermittelt werden.
- Schema bezeichnet das Protokoll oder Adressierungsschema, etwa https oder http.
- Pfad bezeichnet die Pfadkomponente, zum Beispiel /account/orders/42.
- Abfrage enthält den Text nach dem Fragezeichen, mit dem die Abfragekomponente beginnt, und vor einem nicht codierten Rautezeichen, zum Beispiel page=2&sort=date.
Das Parsen ist hilfreich, wenn du API-Anfragen, Callback-URLs, Anwendungsprotokolle oder Daten von Drittanbietern untersuchst. So kannst du Routing-Informationen von Abfrageparametern unterscheiden, bevor du Fehler suchst, die Adresse protokollierst oder sie umwandelst.
Die zurückgegebenen Felder enthalten keinen separaten Hostnamen, Port oder Fragment. Wenn du diese Bestandteile benötigst, verwende in deiner Anwendung eine umfassendere Bibliothek zum Parsen von URLs.
Wie verwende ich den URL-Parser?
Gib eine vollständige oder unvollständige URL ein und prüfe die vom Tool zurückgegebenen Werte für Schema, Pfad und Abfrage. Eine vollständige absolute URL liefert meist das eindeutigste Ergebnis, da sie das Schema ausdrücklich angibt.
- Kopiere die URL aus dem Browser, einer API-Antwort, einem Webhook-Eintrag oder einem Serverprotokoll.
- Übernimm die Abfragezeichenfolge, wenn du Parameternamen oder Werte untersuchen möchtest.
- Vergleiche den zurückgegebenen Pfad mit der Route, die deine Anwendung erwartet.
- Prüfe, ob Schema und Abfrage dort vorhanden sind, wo deine Integration sie benötigt.
Die Verarbeitung findet auf dem Server statt. Deine Eingabe wird über HTTPS an den Server übertragen und nicht gespeichert. Vermeide es trotzdem, aktive Zugriffstoken, signierte Downloadlinks, Sitzungskennungen oder andere Zugangsdaten einzugeben, wenn ein bereinigtes Beispiel dieselbe Frage beantwortet.
Beispiele und Auswertung der Ergebnisse
Bei einer absoluten API-URL trennt der Parser das Protokoll von der Route und der unverarbeiteten Abfragezeichenfolge.
Eingabe https://api.example.co.uk/v1/orders/42?expand=items¤cy=GBP
Schema https
Pfad /v1/orders/42
Abfrage expand=items¤cy=GBP
Die Abfrage wird als eine zusammenhängende Komponente zurückgegeben. Nach der üblichen Konvention für Formulardaten und Abfragezeichenfolgen trennt das kaufmännische Und einzelne Felder. Das erste Gleichheitszeichen in jedem Feld trennt dessen Namen vom Wert. Das Parsen der URL bestätigt jedoch nicht, dass expand oder currency ein von der API unterstützter Parameter ist.
Auch eine relative Referenz kann einen Pfad und eine Abfrage enthalten, ohne ein Schema anzugeben.
Eingabe /search?q=red%20shoes&page=2
Schema no scheme component
Pfad /search
Abfrage q=red%20shoes&page=2
Bei Links, die innerhalb einer Website erzeugt werden, ist ein fehlendes Schema oft zu erwarten. Bei Daten, die absolute Callback-URLs enthalten sollten, kann dasselbe Ergebnis jedoch auf ein fehlendes Präfix https:// hinweisen.
Dieser Parser ist kein URL-Validator. Er kann auffällige Strukturen sichtbar machen, etwa ein fehlendes Schema, einen unerwarteten Pfad oder Abfragetext an der falschen Stelle. Ein geparstes Ergebnis beweist jedoch nicht, dass die Adresse existiert, per DNS aufgelöst werden kann oder eine erfolgreiche HTTP-Antwort liefert.
Was passiert bei Leerzeichen, Satzzeichen und ungewöhnlichen Eingaben?
Reservierte Zeichen beeinflussen, wie eine URL aufgeteilt wird. Codierte Zeichen bleiben dagegen in der Regel Bestandteil der jeweiligen Komponente. Der Parser trennt die Komponenten, decodiert oder normalisiert deren Inhalte aber nicht.
- Ein nicht codiertes Fragezeichen leitet die Abfragekomponente ein. Soll ein Fragezeichen außerhalb einer bestehenden Abfrage als Datenzeichen dienen, sollte es prozentcodiert werden, wenn es sonst als Trennzeichen für die Abfrage interpretiert würde.
- Ein kaufmännisches Und trennt üblicherweise Abfrageparameter. Dieses Tool gibt jedoch die vollständige Abfragezeichenfolge zurück, statt die einzelnen Parameter separat auszuwerten.
- Ein nicht codiertes Rautezeichen (#) dient in der standardmäßigen URL-Syntax als Trennzeichen für das Fragment. Fragmentdaten gehören nicht zu den hier zurückgegebenen Feldern.
- Leerzeichen sollten normalerweise codiert werden, üblicherweise als %20. In formularcodierten Abfragedaten kann ein Pluszeichen für ein Leerzeichen stehen. Diese Interpretation gehört jedoch zur Decodierung der Abfrage und nicht zum Parsen der URL.
- Text mit Akzentzeichen und nicht lateinischer Text in Pfaden oder Abfragen sollten mit UTF-8-Prozentcodierung übertragen werden, wenn das empfangende System dies verlangt. Internationalisierte Domainnamen verwenden für eine breite Protokollkompatibilität ihre ASCII-kompatible Form.
- Zahlen werden beim Parsen nicht besonders behandelt. Sie bleiben normale Zeichen innerhalb eines Pfads oder Abfragewerts.
Eine leere Eingabe enthält keine verwertbare URL-Struktur, die untersucht werden könnte. Bei sehr langen URLs können zudem an anderer Stelle Beschränkungen greifen, etwa in Browsern, Webservern, Proxys und Anwendungsframeworks. Dieses Tool stellt nicht fest, ob ein anderes System eine bestimmte URL-Länge akzeptiert.
Wann lohnt es sich, eine URL zu parsen?
Das Parsen lohnt sich, wenn du den Aufbau einer Adresse prüfen möchtest, bevor Code oder Infrastruktur sie verarbeitet. Typische Anwendungsfälle sind die Kontrolle von Webhook-Callback-Adressen vor der Bereitstellung, die Prüfung von Weiterleitungszielen, das Trennen von API-Routen und Filtern sowie das Lesen von URLs aus Reverse-Proxy-Protokollen.
In der Regel ist es nicht nötig, wenn ausschließlich ein System eine bekannte, bereits strukturierte URL verarbeitet und deine Anwendung schon eine URL-Bibliothek verwendet. Es ist auch nicht das richtige Verfahren, wenn du die Erreichbarkeit testen, Weiterleitungen verfolgen, sämtliche Abfrageparameter decodieren oder die Vertrauenswürdigkeit einer Domain überprüfen möchtest.
Für wiederkehrende oder automatisierte Aufgaben solltest du die URL-Funktionen deiner jeweiligen Umgebung verwenden. PHP bietet parse_url, Browser-JavaScript die URL-Schnittstelle, Node.js die URL-Klasse und Python urllib.parse. Wenn du eine Protokolldatei mit Tausenden von Adressen verarbeitest, ist ein kleines Kommandozeilenskript besser geeignet als manuelles Parsen.
Parse eine URL nicht nur, um sie neu zu formatieren, wenn sie bereits genau in der vom empfangenden System benötigten Form vorliegt. Werden Adressen ohne klaren Grund neu codiert oder zusammengesetzt, können sich Abfragesignaturen, doppelte Parameter oder reservierte Zeichen verändern.
Häufig gestellte Fragen
Kann ich eine URL ohne http oder https parsen?
Ja, die PHP-Funktion parse_url kann relative Referenzen und unvollständige URLs verarbeiten. Wurde kein Schema angegeben, steht allerdings auch keines zur Verfügung. Sei bei schemarelativen Adressen vorsichtig, die mit zwei Schrägstrichen beginnen, da ihre Bedeutung vom umgebenden Dokument oder von der jeweiligen Anwendung abhängt.
Bleiben mehrfach vorkommende Abfrageparameter erhalten?
Die Abfrage wird als unverarbeitete Komponente zurückgegeben. Wiederholte Namen können daher in ihrer ursprünglichen Reihenfolge erhalten bleiben. Wie Werte wie tag=red&tag=blue anschließend in Arrays oder Einzelwerte umgewandelt werden, hängt vom danach eingesetzten Parser für Abfragezeichenfolgen ab.
Kann ich eine signierte URL bedenkenlos einfügen?
Die Eingabe wird über HTTPS übertragen und nicht gespeichert. Eine signierte URL kann jedoch weiterhin Zugriff auf private Inhalte gewähren, solange ihre Signatur gültig ist. Entferne das Token oder ersetze den Hostnamen und die Werte durch repräsentative Platzhalter, wenn die genauen Zugangsdaten nicht benötigt werden.
Warum verhält sich eine gültig aussehende URL in meiner Anwendung anders?
Unterschiede können durch die frameworkspezifische Decodierung von Abfragen und die Unicode-Normalisierung entstehen. Anwendungen können nach dem Parsen außerdem zusätzliche Regeln anwenden, darunter Positivlisten für Hostnamen und Beschränkungen für Weiterleitungen. Vergleiche die unverarbeitete URL Byte für Byte. Prüfe anschließend, was deine Anwendung decodiert oder umschreibt, bevor sie die Anfrage sendet.
Beliebte Werkzeuge
Erstellen Sie Ihre eigene benutzerdefinierte Signatur und laden Sie sie einfach mit unserem Signaturgenerator-Tool für personalisierte E-Signaturen herunter.
Berechnen Sie die Größe eines beliebigen Textes in Bytes (B), Kilobytes (KB) oder Megabytes (MB) mit unserem Textgrößenrechner.
Verwenden Sie das Reverse-IP-Lookup-Tool, um die Domain oder den Host zu finden, der mit einer IP-Adresse verknüpft ist, schnell und einfach.
Verwenden Sie unser Ping-Tool, um den Status und die Antwortzeit einer beliebigen Website, eines Servers oder Ports schnell und effizient zu überprüfen.
Das IP-Lookup-Tool von Digily Link bietet detaillierte Informationen zu jeder IP-Adresse. Nutzen Sie diesen kostenlosen Online-Dienst, um umfassende IP-Daten zu erhalten.
Erstellen Sie mit unserem WhatsApp-Link-Generator sofort Ihren kostenlosen WhatsApp-Link. Fügen Sie eine benutzerdefinierte Nachricht hinzu und starten Sie Chats mit einem Klick, ganz ohne Anmeldung oder Programmierung.