Controllo dei meta tag
Recupera e verifica i meta tag di qualsiasi sito web utilizzando il nostro strumento di controllo dei meta tag per ottimizzare il tuo SEO.
Il Controllo dei meta tag è uno strumento gratuito che recupera e verifica i meta tag di qualsiasi sito web, così puoi controllare come una pagina si presenta ai motori di ricerca e agli altri servizi.
Che cosa verifica il controllo dei meta tag?
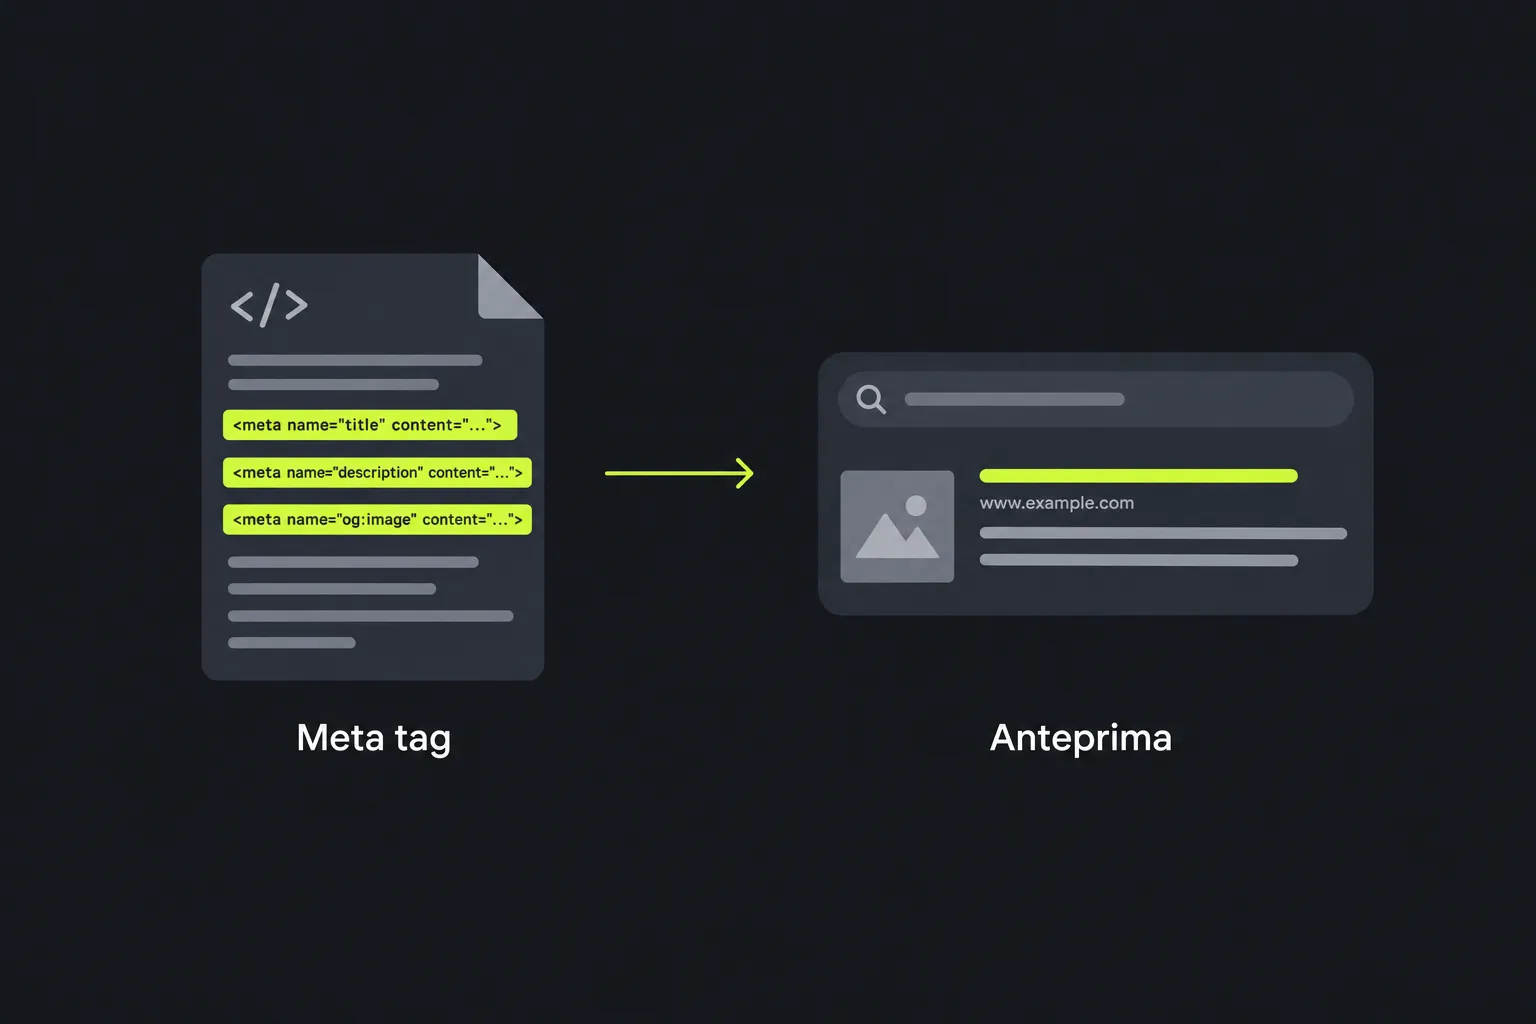
Il controllo recupera e verifica i meta tag presenti nel codice HTML di una pagina web. I metadati forniscono ai crawler e ai servizi di condivisione istruzioni o informazioni descrittive sulla pagina.
Tra gli elementi più utili da esaminare ci sono la meta description, le direttive robots, le impostazioni del viewport e i metadati per la condivisione sui social, come i tag Open Graph. L'URL canonico viene normalmente indicato tramite un elemento link HTML separato e va quindi controllato a parte. Anche il titolo del documento è tecnicamente un elemento HTML, non un meta tag, ma viene spesso verificato insieme ai metadati perché i motori di ricerca possono usarlo come titolo di un risultato.
Questi elementi possono influire in modi diversi sulla visibilità o sulla presentazione della pagina. Una direttiva robots può impedirne l'indicizzazione. Separatamente, un link canonico può indicare quale versione di pagine simili debba essere considerata quella principale. Le descrizioni e i metadati social possono influenzare il modo in cui viene presentato un link, ma i motori di ricerca e le piattaforme social possono scegliere di generare autonomamente testo o immagini.
Il vecchio tag meta keywords non fornisce un segnale utile per l'ottimizzazione sui principali motori di ricerca. La sua presenza è generalmente innocua, ma dedicare tempo alla compilazione di elenchi di parole chiave difficilmente migliorerà la visibilità nei risultati di ricerca.
Come posso controllare i meta tag di un sito?
Inserisci l'URL pubblico completo della pagina da esaminare, avvia il controllo e verifica i metadati recuperati. Controlla la pagina esatta, senza presumere che tutte le pagine dello stesso sito usino le impostazioni della home page.
- Quando possibile, usa l'indirizzo HTTPS finale, includendo il percorso completo nel caso di un articolo, un prodotto o un profilo.
- Verifica se l'URL inserito viene reindirizzato e, in tal caso, controlla anche la destinazione mostrata nel browser.
- Confronta i valori restituiti con lo scopo della pagina e con il modo in cui dovrebbe apparire nei risultati di ricerca.
- Apporta le modifiche nel template del sito, nel sistema di gestione dei contenuti o nelle impostazioni SEO, pubblicale e poi ripeti il controllo.
Il controllo viene eseguito sul server. L'URL inserito viene trasmesso al server tramite HTTPS e non viene memorizzato. Perché uno strumento lato server possa recuperarla, la pagina di destinazione deve essere accessibile dalla rete internet pubblica. I link di anteprima privati, le pagine intranet e quelle protette da accesso potrebbero non essere raggiungibili.
I dettagli dell'URL sono importanti. Una stringa di query può produrre una risposta diversa, mentre un frammento che inizia con un cancelletto non viene inviato al server web. Gli spazi non sono caratteri letterali validi negli URL e normalmente devono essere codificati con la codifica percentuale. I nomi di dominio accentati o con caratteri non latini possono essere rappresentati secondo IDNA come etichette ASCII in Punycode, mentre i caratteri non latini nel percorso possono apparire codificati in percentuale.
Come si interpreta il risultato?
Esamina ogni meta elemento restituito controllandone gli attributi, come name, property, http-equiv, charset e, quando applicabile, content. Verifica inoltre che corrispondano alla pagina inserita. Un tag può essere presente ma comunque errato, duplicato o ereditato da un template non adatto.
- Meta description deve descrivere in modo naturale la pagina specifica. Un valore vuoto non propone alcun riepilogo al motore di ricerca, che può comunque generarne uno partendo dal testo visibile.
- Robots fornisce direttive che i crawler conformi possono seguire. Ad esempio, robots = noindex, follow chiede ai crawler conformi di non indicizzare la pagina, consentendo però di seguirne i link.
- Canonical va controllato separatamente perché normalmente è un elemento link HTML, non un meta elemento. Il suo href identifica l'URL preferito per contenuti duplicati o quasi identici. In genere dovrebbe rimandare a una pagina valida e indicizzabile che rappresenti lo stesso contenuto.
- Viewport aiuta i browser a disporre correttamente la pagina sui dispositivi mobili. Non descrive direttamente la pagina, ma un valore assente o non adatto può contribuire a una visualizzazione mobile poco efficace.
- Open Graph e tag social simili propongono un titolo, una descrizione, un URL o un'immagine da mostrare quando la pagina viene condivisa. Ogni piattaforma decide quali valori utilizzare effettivamente.
Per fare un esempio concreto, in una pagina prodotto il valore description = Red wool scarf with tasselled ends descrive in modo specifico l'articolo. Se la stessa pagina restituisce description = Welcome to our website, il tag è presente ma offre poche informazioni utili. Allo stesso modo, controllando separatamente il link canonico, un href pari a https://example.co.uk/scarves/red-wool-scarf è appropriato per quel prodotto, mentre un canonical che rimanda alla home page del negozio potrebbe far considerare duplicato l'URL del prodotto.
Nessuno strumento di controllo dei metadati può garantire il posizionamento, l'indicizzazione o l'esatto snippet mostrato nei risultati. I motori di ricerca valutano l'intera pagina, i link, l'accesso dei crawler e molti altri segnali. Possono inoltre riscrivere titoli o descrizioni in base a una determinata query.
Problemi comuni e soluzioni pratiche
- Descrizione mancante. Aggiungi una descrizione specifica per la pagina tramite il sistema di gestione dei contenuti o il template. Evita di copiare la stessa frase in un gran numero di pagine.
- Direttiva noindex involontaria. Quando le pagine sono pronte per la pubblicazione e devono comparire nei risultati di ricerca, rimuovila. Controlla anche gli header della risposta HTTP, perché le istruzioni robots possono essere fornite lì anziché nel codice HTML.
- Più copie dello stesso tag. Individua quale tema, plug-in o componente del template aggiunge ogni copia e mantieni un solo valore autorevole. Direttive robots in conflitto o elementi link canonical duplicati rendono più difficile individuare il problema.
- Link canonico errato. Controllalo separatamente dai meta tag e sostituisci un valore predefinito applicato all'intero sito con l'URL preferito per il contenuto corrente. Presta attenzione a HTTP rispetto a HTTPS, alle varianti del nome host e ai parametri di tracciamento non necessari.
- Titolo o immagine social non aggiornati. Aggiorna i campi della pagina dedicati alla condivisione e verifica che l'URL dell'immagine sia pubblico. Alcune piattaforme memorizzano le anteprime nella cache, quindi il tag corretto potrebbe non comparire immediatamente.
- Metadati provenienti da un'altra pagina. Controlla le variabili del template e i flussi di pubblicazione. Succede spesso quando si duplica un prodotto, un evento o un articolo esistente senza sostituire tutti i campi.
I metadati aggiunti solo dopo l'esecuzione di JavaScript lato client potrebbero non essere visibili a tutti i crawler o servizi di controllo. Per i metadati che forniscono direttive di indicizzazione e per gli elementi link separati che indicano la canonicalizzazione, l'inserimento nel codice HTML inviato dal server è generalmente più affidabile.
Ogni quanto conviene controllare i meta tag?
Controlla nuovamente i metadati dopo aver pubblicato un nuovo template, modificato un plug-in SEO, trasferito un dominio o cambiato le impostazioni di indicizzazione. È utile eseguire controlli periodici anche dopo importazioni massive di contenuti e aggiornamenti che modificano gli header delle pagine.
Serve a poco controllare ripetutamente ogni pochi minuti una pagina che non è cambiata. Ripeti il controllo dopo una modifica al codice HTML pubblicato, dopo aver corretto un reindirizzamento oppure quando una piattaforma ha avuto il tempo di svuotare la cache dell'anteprima. Per un sito di grandi dimensioni, verifica diversi tipi di pagina anziché limitarti alla home page. Includi un articolo, una categoria, un prodotto, una pagina con paginazione e qualsiasi template che debba rimanere escluso dai risultati di ricerca.
Domande frequenti
Il controllo rileva i meta tag aggiunti tramite JavaScript?
Dipende dal fatto che il servizio esegua JavaScript oppure legga soltanto la risposta HTML iniziale. Non dare per scontato che vengano rilevati i tag inseriti tramite script. Se un tag compare negli strumenti per sviluppatori del browser ma non nel controllo, esamina il codice sorgente inviato dal server.
Perché la pagina controllata è diversa dall'URL che ho inserito?
L'indirizzo inserito potrebbe reindirizzare a un altro URL per imporre l'uso di HTTPS, uniformare il nome host, normalizzare la barra finale o gestire una modifica allo slug della pagina. In alcuni casi, il motivo può essere l'instradamento regionale o la rimozione di un parametro di tracciamento. Controlla la destinazione finale, perché è da quella pagina che potrebbero essere recuperati i metadati.
Posso controllare un sito di staging o una pagina protetta da password?
Di solito no, a meno che la pagina sia accessibile pubblicamente e lo strumento possa raggiungerla senza credenziali. Per le pagine protette, esamina invece in locale il codice HTML dopo il rendering.
Ogni pagina deve avere metadati diversi?
Le pagine con finalità diverse dovrebbero generalmente avere titoli e descrizioni che ne rispecchino i contenuti. L'eventuale link canonico, da controllare separatamente dai meta tag, dovrebbe puntare all'URL preferito corretto. Per le pagine filtrate duplicate serve una strategia di canonicalizzazione consapevole. Le copie distribuite in syndication richiedono una gestione adeguata agli accordi di pubblicazione. Le pagine tradotte dovrebbero usare le annotazioni linguistiche appropriate, anziché essere trattate come duplicati.
Che cosa devo fare dopo aver corretto un tag?
Pubblica la modifica, svuota le eventuali cache pertinenti del sito e controlla di nuovo l'URL pubblico finale. Quindi esamina la pagina con il servizio diagnostico del motore di ricerca o della piattaforma social, se disponibile, perché questi servizi possono applicare regole proprie per rendering, memorizzazione nella cache e idoneità.
Strumenti popolari
Crea la tua firma personalizzata e scaricala facilmente con il nostro strumento generatore di firme per e-firme personalizzate.
Calcola la dimensione di qualsiasi testo in Byte (B), Kilobyte (KB) o Megabyte (MB) utilizzando il nostro strumento calcolatore di dimensioni del testo.
Utilizza lo strumento di ricerca inversa IP per trovare il dominio o l'host associato a qualsiasi indirizzo IP in modo rapido e semplice.
Utilizza il nostro strumento di ping per controllare rapidamente ed efficacemente lo stato e il tempo di risposta di qualsiasi sito web, server o porta.
Lo strumento di ricerca IP di Digily Link fornisce informazioni dettagliate su qualsiasi indirizzo IP. Utilizza questo servizio online gratuito per ottenere dati IP completi.
Genera subito il tuo link WhatsApp gratuito con il nostro generatore di link WhatsApp. Aggiungi un messaggio personalizzato e avvia chat con un clic, senza accesso né programmazione.