Extrator de URL
O Extrator de URL é uma ferramenta gratuita que encontra URLs HTTP e HTTPS em textos colados e informa quantas foram encontradas.
Como extrair URLs de um texto?
Cole o texto de origem no campo de entrada, inicie a extração e confira a Contagem.
- Copie o texto que contém os endereços da web.
- Cole o conteúdo na ferramenta e inicie a extração.
- Confira a Contagem.
A contagem é útil quando você já sabe aproximadamente quantos links deveriam aparecer. Se o briefing de uma campanha diz que contém 20 referências, mas o resultado mostra 19, você pode verificar o texto de origem antes de encaminhá-lo.
Quando extrair URLs poupa tempo?
A extração de URLs poupa tempo sempre que os links estão misturados com frases, rótulos, comentários ou outros dados desnecessários.
- Registros de suporte: reúna links de chamados copiados do Zendesk ou de conversas do Microsoft Teams antes de investigar as páginas relatadas.
- Trabalho com conteúdo: extraia referências de um documento do Word ou de um rascunho de artigo no WordPress ao verificar fontes, redirecionamentos ou links internos.
- Exportações de planilhas: recupere endereços da web de anotações exportadas do Google Sheets ou do Excel sem precisar conferir cada célula manualmente.
- Preparação de mala direta: separe os links de destino do texto descritivo antes de inseri-los em uma coluna de URLs de um arquivo CSV.
- Verificações de migração: encontre links absolutos no conteúdo copiado de páginas antes de transferir artigos entre sistemas de gerenciamento de conteúdo.
O que é considerado uma URL?
Para esta ferramenta, os endereços relevantes são URLs que começam com http:// ou https://. Um domínio isolado, como example.org, um endereço com www sem esquema, um endereço de e-mail e um caminho relativo, como /contact, são formas diferentes de dados.
Uma URL pode conter domínio, porta, caminho, string de consulta e fragmento. Números são válidos nesses componentes. Espaços literais não são caracteres válidos em URLs e normalmente são codificados, muitas vezes como %20, embora vários sistemas modernos usem outras estruturas no lugar de espaços.
Nomes de domínio internacionalizados podem aparecer como texto Unicode ou no formato Punycode compatível com ASCII. Como a extração de texto depende da correspondência de padrões de caracteres, verifique esses endereços com atenção em vez de presumir que todos os aplicativos os interpretarão da mesma forma.
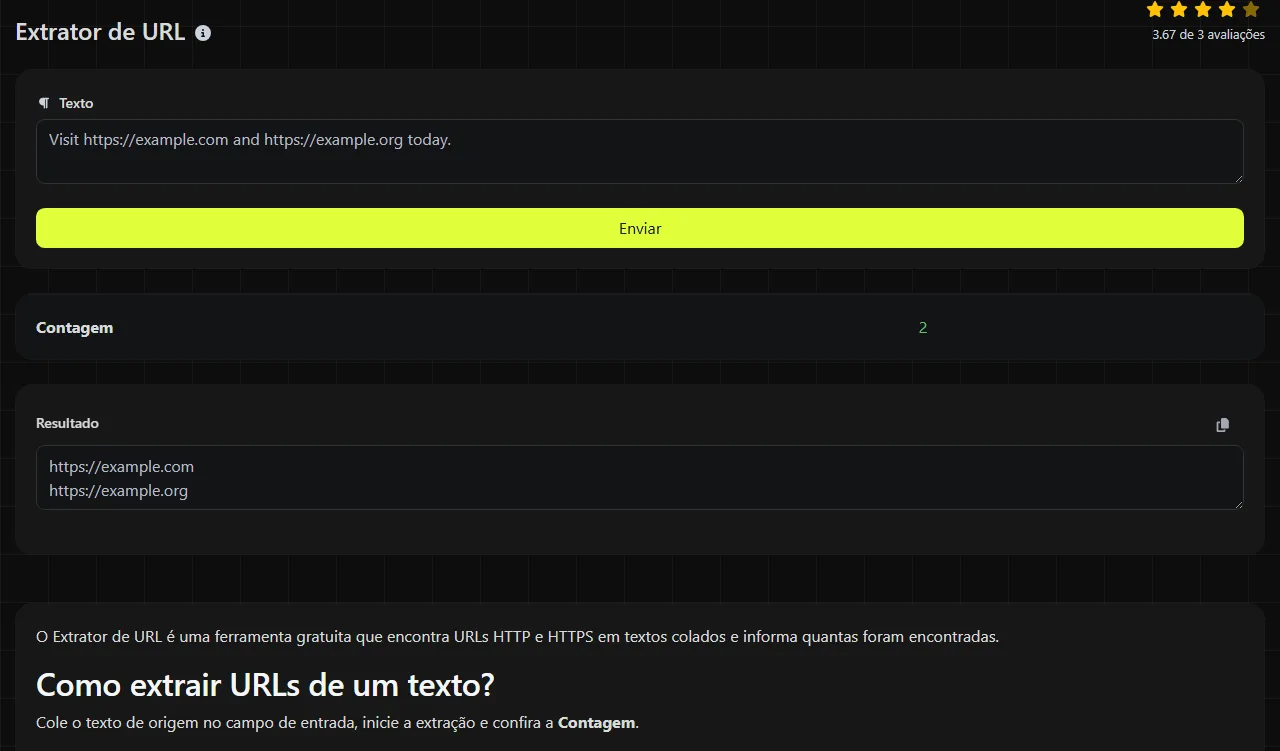
Exemplos práticos de entrada e saída
Entrada
Project brief https://example.org/brief
Archive copy http://example.net/archive
Count 2
Uma URL também pode incluir um caminho e parâmetros de consulta.
Entrada
Review order https://example.org/orders/1042?status=open
Count 1
Como conferir entradas mais complicadas?
Examine as correspondências que encostam em sinais de pontuação, parênteses, colchetes ou quebras de linha, pois o texto simples nem sempre deixa claro onde a URL deveria terminar. Um ponto final pode pertencer à frase ao redor. Caracteres reservados literais, incluindo vírgulas, parênteses e colchetes, só são permitidos em contextos específicos de uma URL. Quando codificados por porcentagem, eles aparecem como sequências de bytes codificadas por porcentagem, e não como caracteres literais.
Um texto que não contenha nenhum endereço HTTP ou HTTPS não tem uma URL válida para extração.
A ferramenta usa correspondência de padrões, sem compreender o significado de cada página. Ela não consegue deduzir um esquema ausente, corrigir um link dividido entre linhas nem decidir se um sinal de pontuação próximo foi digitado por engano.
Perguntas frequentes
A ferramenta extrai endereços com www, mas sem HTTP ou HTTPS?
Não. Adicione o esquema completo, como https://www.example.org, para que o endereço seja tratado como uma URL HTTP ou HTTPS. Não acrescente um esquema indiscriminadamente a textos não confiáveis ou malformados.
O extrator verifica se o link está funcionando?
Não. A correspondência de padrões identifica textos com formato de URL, mas não confirma se o domínio existe, se o servidor responde ou se a página é segura. Verifique os links separadamente antes de publicá-los ou de abrir endereços desconhecidos.
É possível extrair links relativos de um HTML?
A ferramenta consegue identificar URLs HTTP ou HTTPS absolutas presentes no texto colado, inclusive quando aparecem no código-fonte HTML. Um valor relativo, como href="/pricing", não contém o esquema necessário e precisa do endereço base do site para se tornar uma URL absoluta.
O texto que eu colo é enviado para um servidor?
Sim. O conteúdo é enviado ao servidor por HTTPS, onde a extração é realizada, e não fica armazenado. Evite colar segredos, senhas ou tokens de acesso privados em qualquer ferramenta de texto, especialmente quando aparecem nas strings de consulta de uma URL.
A extração remove parâmetros de rastreamento?
Não presuma que haverá limpeza ou remoção de parâmetros de rastreamento. Antes de compartilhar URLs extraídas do texto de origem, revise as strings de consulta, como tags de campanha, identificadores de sessão e parâmetros assinados, pois elas podem expor informações ou alterar o destino do link.
Ferramentas populares
Gere facilmente sua própria assinatura personalizada e faça o download com facilidade.
Obtenha o tamanho de um texto em Bytes (B), Kilobytes (KB) ou Megabytes (MB).
Use a ferramenta de consulta reversa de IP para encontrar de forma rápida e fácil o domínio ou host associado a qualquer endereço IP.
Use nossa ferramenta de ping para verificar de forma rápida e eficiente o status e o tempo de resposta de qualquer site, servidor ou porta.
A ferramenta de consulta de IP do Digily Link fornece informações detalhadas sobre qualquer endereço IP. Use este serviço online gratuito para obter dados completos de IP.
Gere instantaneamente seu link gratuito do WhatsApp com nosso gerador de links. Adicione uma mensagem personalizada e inicie conversas com um clique, sem login nem programação.