谷歌缓存查询
使用我们的谷歌缓存查询工具检查URL是否被Google缓存,以确保内容的可访问性。
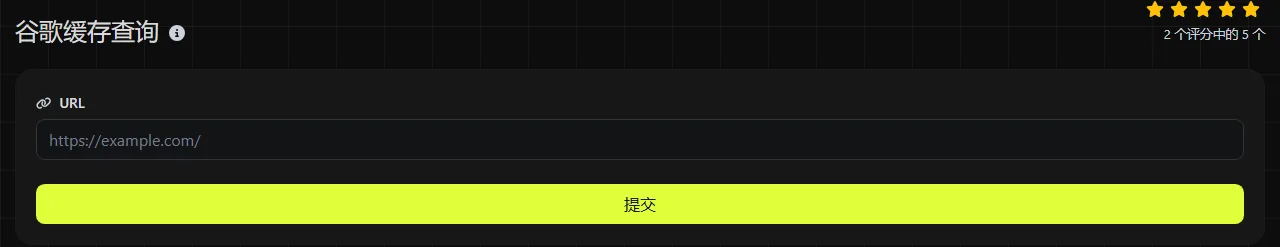
谷歌缓存查询是一款免费工具,可检查指定 URL 是否存在谷歌缓存副本,并在未找到缓存时给出提示。
谷歌缓存查询结果到底能说明什么?
谷歌缓存查询会查找相关记录,判断谷歌是否保存了某个网页的可访问副本。过去,缓存副本通常是谷歌上次抓取该网页时生成的快照,并非网站当前提供的实时版本。
缓存和索引并不是一回事。已编入索引的 URL 可能会出现在 Google 搜索中,而存在缓存的 URL 则曾有可供用户打开的网页快照。网页可以已被索引,却没有公开可访问的缓存副本。因此,未查到缓存并不能证明谷歌已将该网页从索引中删除。
谷歌已于 2024 年停止提供公开的网页缓存链接。因此,是否存在缓存已不能作为判断索引状态的可靠依据。如果是你管理的网站,请使用 Google Search Console 的网址检查工具,查看网页发现、抓取、规范网址选择和索引方面的相关信息。
如何看懂查询结果?
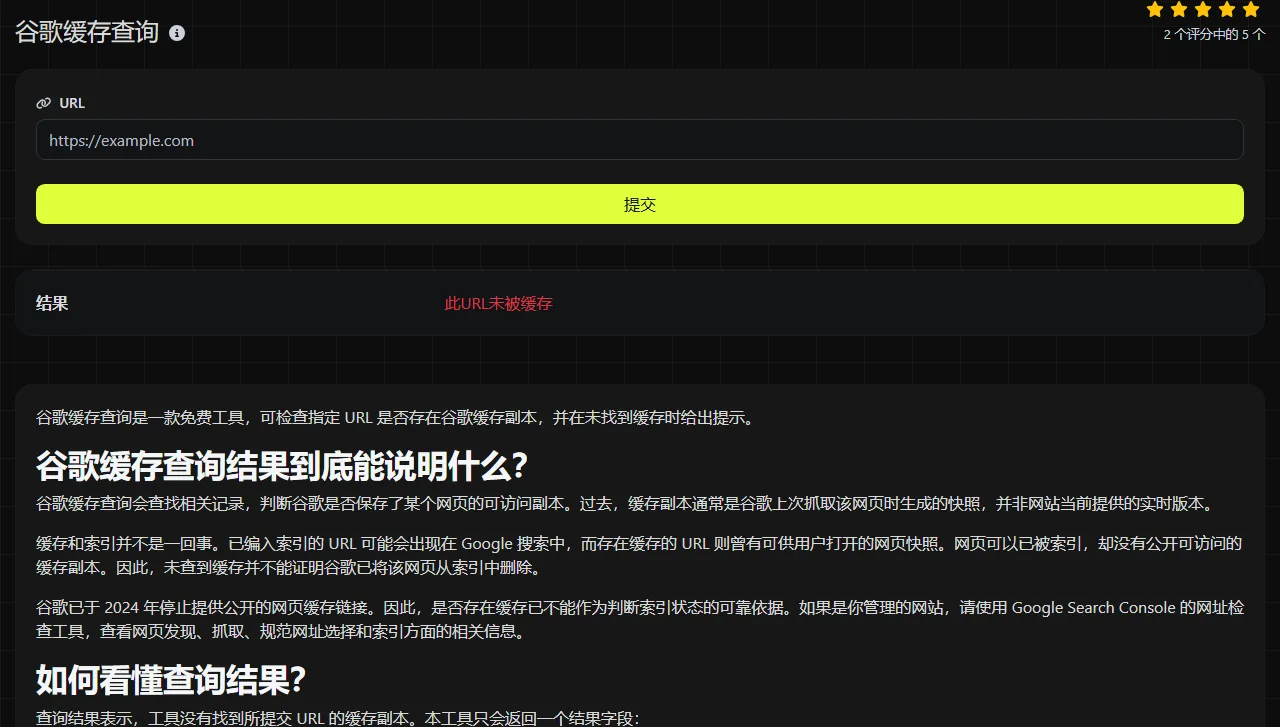
查询结果表示,工具没有找到所提交 URL 的缓存副本。本工具只会返回一个结果字段:
- 此URL未被缓存 未发现与所提交地址完全一致的谷歌缓存副本。这不能确认该网页未出现在搜索结果中、被禁止抓取或存在技术故障。
查询针对的是你输入的完整 URL,包括主机名、路径和参数。以下地址可能代表不同的资源:
- https://www.example.co.uk/guide
- https://example.co.uk/guide
- https://www.example.co.uk/guide/
- https://www.example.co.uk/guide?source=email
网站可能会将其中部分或全部地址重定向到首选地址。如果不确定谷歌最终访问的是哪个版本,请使用 URL重定向查询确认最终目标地址,再到 Search Console 中检查该地址。
哪些情况下适合使用此查询?
当你要调查旧的搜索快照,或想了解某个 URL 为什么似乎没有缓存副本时,可以运行此查询。但缓存结果无法确定该 URL 是否已被索引。
- 网页最近有过改动。 你可能想知道旧版副本是否仍然可用。未查到缓存表示本次查询没有发现旧副本,但搜索摘要仍可能显示谷歌在较早一次抓取时收集的信息。
- 新网页没有出现在搜索结果中。 先检查实际发布的准确 URL,再通过 Search Console 查看谷歌是否已发现该网页并将其编入索引。同时确认网页返回成功的 HTTP 状态码,并且未被 noindex 指令排除。
- 网站更换了域名或 URL 结构。 检查旧地址到新地址的重定向。无论是否存在缓存副本,谷歌都可能需要一段时间来抓取重定向、选择规范网址并更新搜索结果。
DNS 解析失败、邮件无法送达和浏览器证书警告,涉及 DNS、邮件配置或 TLS 证书。网站托管查询可以帮助你确定正常运行的网站托管在哪里,但无法诊断所有 DNS 或证书故障。
缓存、索引与传播延迟
如果同时涉及多个彼此独立的缓存和更新周期,即使查询结果正确,看起来也可能不符合预期。谷歌会自行决定何时再次访问网页,服务器上的改动不会立即反映在搜索结果中。搜索摘要、规范网址信息和已索引内容也可能在不同时间更新。
DNS 更改也有自己的生效延迟。递归 DNS 解析器会在记录的生存时间内保留记录,该时间通常称为 TTL。因此,一些访问者可能仍会连接旧服务器,而另一些访问者已经连接新服务器。浏览器缓存、反向代理和内容分发网络也可能保留旧文件。这些缓存都不等同于谷歌网页缓存。
如果最近编辑的网页看起来仍是旧版,请打开实时 URL,检查其 HTTP 响应,并清除或绕过你可以控制的缓存。然后在 Search Console 中检查该 URL。反复查询缓存并不能让谷歌更快地重新抓取网页。
如何处理包含空格或非 ASCII 字符的 URL?
提交的地址会在服务器端通过 PHP 的 urlencode 操作进行 URL 编码。该操作遵循 application/x-www-form-urlencoded 约定,将空格转换为加号,并对其他非安全字节进行百分号编码。
例如,文本 https://www.example.co.uk/search?q=cream tea 会被编码为 https%3A%2F%2Fwww.example.co.uk%2Fsearch%3Fq%3Dcream+tea。在这种编码方式下,空格会变成加号。带重音符号的 UTF-8 值,例如 café,则会变成 caf%C3%A9。
这种编码格式会原样接受数字,而斜杠、问号和等号等标点符号会被编码。国际化域名可能包含 IDNA A-label,该标签使用 xn-- 前缀和 Punycode 编码。
本工具在服务器端执行的 urlencode 处理不会修复无效或不完整的 URL。空值没有可供查询的网页,而很长的地址可能超过请求路径中其他环节的限制。请直接从浏览器复制地址,不要凭记忆手动输入。
常见问题
未查到缓存,是否说明我的网页已被移出索引?
不是。公开缓存是否可用与搜索索引是两回事,而且谷歌已不再提供以前的网页缓存链接。请在 Google Search Console 中检查该 URL,或搜索网页中一句具有辨识度的文本,但要注意,普通搜索查询并不能完整反映索引状态。
URL 中需要保留跟踪参数吗?
除非你明确需要调查带参数的版本,否则请使用简洁的规范网址。utm_source 等参数通常用于标识营销活动带来的访问,而不是区分不同内容,谷歌可能会将这些 URL 归并到同一个规范网址下。
可以查询私有网页或受密码保护的网页吗?
除非明确获得访问权限,否则抓取工具通常无法获取需要登录才能查看的内容,因此不应指望这类网页存在公开的搜索缓存。你提交的 URL 会通过 HTTPS 传输到本工具的服务器进行处理,并且不会被存储。因此,请勿在 URL 中包含密码、访问令牌或其他机密信息。
URL 片段会影响谷歌看到的网页吗?
通常不会。片段是井号之后的部分,例如 #delivery。浏览器通常不会在 HTTP 请求中发送片段,因此,两个普通 URL 如果只有片段不同,通常会获取同一份文档。排查网页本身的索引问题时,请使用不含片段的地址进行检查。
申请重新抓取前应该检查什么?
先确认首选 URL 可以正常加载,不存在重定向循环,返回成功响应,允许 Googlebot 抓取,并且不包含误加的 noindex 指令。还要检查其 canonical 链接类型的 link 元素,确保 href 值指向预期 URL。如果你管理该网站,再通过 Search Console 申请编入索引。