Usuwanie zduplikowanych linii
Usuń zduplikowane linie z dowolnego tekstu szybko i łatwo za pomocą naszego narzędzia do usuwania zduplikowanych linii, aby uzyskać czystą i zorganizowaną treść.
Usuwanie zduplikowanych linii to bezpłatne narzędzie, które usuwa powtarzające się wiersze z wklejonego tekstu i podaje liczbę pozostałych wierszy.
Jak usunąć zduplikowane wiersze?
Wklej tekst zawierający po jednej pozycji w każdym wierszu, uruchom narzędzie, a następnie skopiuj oczyszczony wynik.
- Przygotuj dane tak, aby każdy adres e-mail, adres URL, kod produktu lub inna wartość znajdowały się w osobnym wierszu.
- Prześlij tekst do usunięcia duplikatów.
- Sprawdź podane liczby i przejrzyj oczyszczone wiersze, zanim wykorzystasz je w innym miejscu.
Narzędzie korzysta z operacji array_unique języka PHP. Jeśli ten sam wiersz występuje więcej niż raz, zachowywane jest jego pierwsze wystąpienie, a kolejne identyczne wystąpienia są usuwane.
Kiedy usuwanie zduplikowanych wierszy oszczędza czas?
Przydaje się zawsze wtedy, gdy na liście pojawiły się powtórzone wpisy wskutek eksportowania, kopiowania lub łączenia danych z kilku źródeł.
- Eksporty z Excela i Arkuszy Google często zawierają powtórzone adresy e-mail, numery referencyjne lub kody magazynowe po połączeniu arkuszy.
- Pliki importowane do Mailchimp mogą wymagać usunięcia powielonych wierszy z adresami e-mail przed przesłaniem. Samo usuwanie wierszy nie sprawdza jednak poprawności adresów ani nie scala oddzielnych rekordów kontaktów.
- Praca z produktami w Shopify może prowadzić do powstawania powtórzonych kodów SKU, gdy wartości są kopiowane z kilku raportów.
- Eksporty z Google Search Console można połączyć w listę adresów URL, po jednym w każdym wierszu, a następnie oczyścić przed dalszą analizą.
- Pliki konfiguracyjne GitHub, w tym proste listy dozwolonych i ignorowanych pozycji, mogą zawierać identyczne wpisy dodane przez różnych współtwórców.
Warto zachować niezmienioną kopię danych źródłowych, aby móc odzyskać wiersze usunięte jako duplikaty. Jeśli pozorny duplikat nie został usunięty, sprawdź go w edytorze zwykłego tekstu, który pozwala zobaczyć spacje na końcu wiersza i inne niewidoczne znaki.
Jak narzędzie traktuje spacje, wielkość liter i znaki interpunkcyjne?
Porównuje pełne wartości wierszy, dlatego nawet niewielkie różnice w ich treści mogą sprawić, że dwa wpisy nie zostaną uznane za identyczne.
Na przykład "Manchester", "manchester" i "Manchester " to trzy różne ciągi znaków ze względu na wielkość liter lub spację na końcu. W porównaniu uwzględniane są również cyfry i znaki interpunkcyjne, dlatego "INV-104" nie odpowiada wartości "INV104". Narzędzie nie rozpoznaje, że dwie odmiennie zapisane wartości mogą odnosić się do tego samego klienta, adresu URL lub produktu.
Tekst ze znakami diakrytycznymi i alfabetami innymi niż łaciński może być przechowywany jako ciągi znaków w wierszach, ale identycznie wyglądający tekst Unicode może składać się z innych sekwencji znaków. Takie wiersze mogą pozostać oddzielne, jeśli tekst nie zostanie wcześniej znormalizowany. Jeżeli do array_unique trafi kilka pustych wierszy jako powtarzające się puste wartości, zachowana zostanie tylko pierwsza pusta wartość.
W przypadku bardzo dużych plików do usunięcia duplikatów z całego zbioru wierszy praktyczniejsze może być użycie polecenia w arkuszu kalkulacyjnym lub skryptu niż wklejanie danych do narzędzia w przeglądarce.
Jak odczytać wynik?
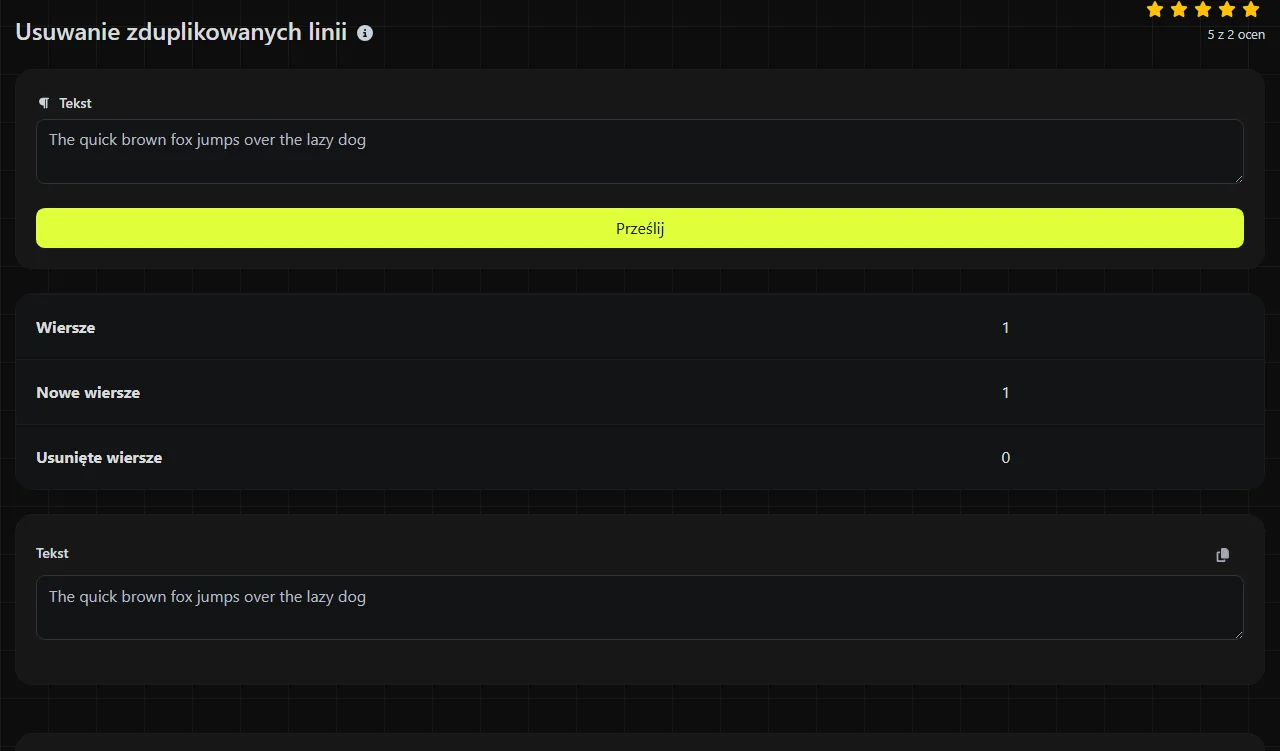
Pola wyniku pokazują początkową liczbę wierszy, liczbę pozostałych wierszy oraz liczbę usuniętych pozycji.
- Wiersze to liczba wierszy na przesłanej liście.
- Nowe wiersze to liczba wierszy po usunięciu zduplikowanych wartości.
- Usunięte wiersze pokazują, ile powtórzonych wartości odrzucono.
Porównaj liczbę usuniętych wierszy ze swoimi oczekiwaniami. Zaskakująco niski wynik często oznacza, że wiersze różnią się spacjami, wielkością liter lub interpunkcją. Zaskakująco wysoki może wskazywać, że powtarzające się wiersze miały znaczenie w danych źródłowych, na przykład reprezentowały oddzielne transakcje o identycznych opisach.
Przykłady usuwania duplikatów
Dla wierszy wejściowych "pear", "apple" i "pear" wynikiem będą wiersze "pear" oraz "apple". Drugie wystąpienie "pear" zostanie usunięte, a kolejność pierwszych wystąpień pozostanie bez zmian.
Wartości "London", "london" i "London " ze spacją na końcu są trzema różnymi wartościami podczas bezpośredniego porównywania ciągów znaków. Ujednolicenie wielkości liter i wcześniejsze usunięcie białych znaków z początku oraz końca wartości wymaga osobnej operacji.
Jeśli wartości są oddzielone przecinkami, a nie znakami końca wiersza, użyj najpierw narzędzia Separator tekstu, aby umieścić każdą wartość w osobnym wierszu. Duplikaty są usuwane na poziomie całych wierszy, a nie poszczególnych słów czy pól rozdzielonych przecinkami w obrębie jednego wiersza.
Najczęściej zadawane pytania
Czy mogę usunąć duplikaty z pliku CSV?
Możesz wkleić zawartość pliku CSV, ale narzędzie porównuje całe wiersze. Nie usunie duplikatów tylko z jednej kolumny, zachowując jednocześnie różne dane w sąsiednich kolumnach. Aby dopasowywać dane według kolumn, użyj polecenia Usuń duplikaty w Excelu, Arkuszy Google lub skryptu obsługującego format CSV.
Dlaczego ponumerowane pozycje listy nie są uznawane za duplikaty?
Numery na początku są częścią wiersza, dlatego "1. Bristol" i "2. Bristol" to różne wartości. Jeśli porównywana ma być nazwa miejsca, usuń numerację przed usunięciem duplikatów.
Czy wklejanie poufnych informacji jest bezpieczne?
Przetwarzanie odbywa się na serwerze. Wprowadzone dane są przesyłane na serwer przez HTTPS i nie są przechowywane, ale podczas przetwarzania opuszczają Twoje urządzenie. Nie przesyłaj danych poufnych ani objętych regulacjami, jeśli zasady obowiązujące w Twojej organizacji zabraniają przekazywania ich do zewnętrznej usługi.
Czy mogę w ten sposób oczyścić JSON lub kod programu?
Automatyczne usuwanie powtórzonych wierszy może uszkodzić JSON, kod źródłowy i inne formaty strukturalne, w których powtarzający się tekst może być zamierzony. Gdy struktura i położenie wiersza wpływają na znaczenie, użyj parsera, narzędzia formatującego lub rozwiązania przeznaczonego dla danego języka.
Kontrola końcowa
Przejrzyj oczyszczoną listę przed jej zaimportowaniem, zwłaszcza jeśli zduplikowane wiersze mogą oznaczać oddzielne zamówienia, płatności lub zdarzenia. Zachowaj oryginalny plik do czasu, aż system docelowy przyjmie poprawione dane, a Ty sprawdzisz wiersze zachowane i usunięte przez narzędzie.
Popularne narzędzia
Utwórz własny podpis i pobierz go łatwo za pomocą naszego narzędzia do generowania podpisów dla spersonalizowanych e-podpisów.
Oblicz rozmiar dowolnego tekstu w bajtach (B), kilobajtach (KB) lub megabajtach (MB) za pomocą naszego narzędzia do obliczania rozmiaru tekstu.
Użyj narzędzia do odwrotnego wyszukiwania IP, aby szybko i łatwo znaleźć domenę lub hosta powiązanego z dowolnym adresem IP.
Użyj naszego narzędzia ping, aby szybko i efektywnie sprawdzić status i czas odpowiedzi dowolnej strony internetowej, serwera lub portu.
Narzędzie do wyszukiwania IP Digily Link dostarcza szczegółowych informacji o dowolnym adresie IP. Skorzystaj z tej darmowej usługi online, aby uzyskać kompleksowe dane o IP.
Wygeneruj swój darmowy link WhatsApp natychmiast za pomocą naszego Generatora Linków WhatsApp. Dodaj niestandardową wiadomość i rozpocznij czaty jednym kliknięciem. Bez logowania i kodowania.