UUID v4 ジェネレーター
UUID v4ジェネレーターを使用して、ユニークな識別のために簡単にv4 UUID(ユニバーサリー・ユニーク・アイデンティファイア)を生成します。
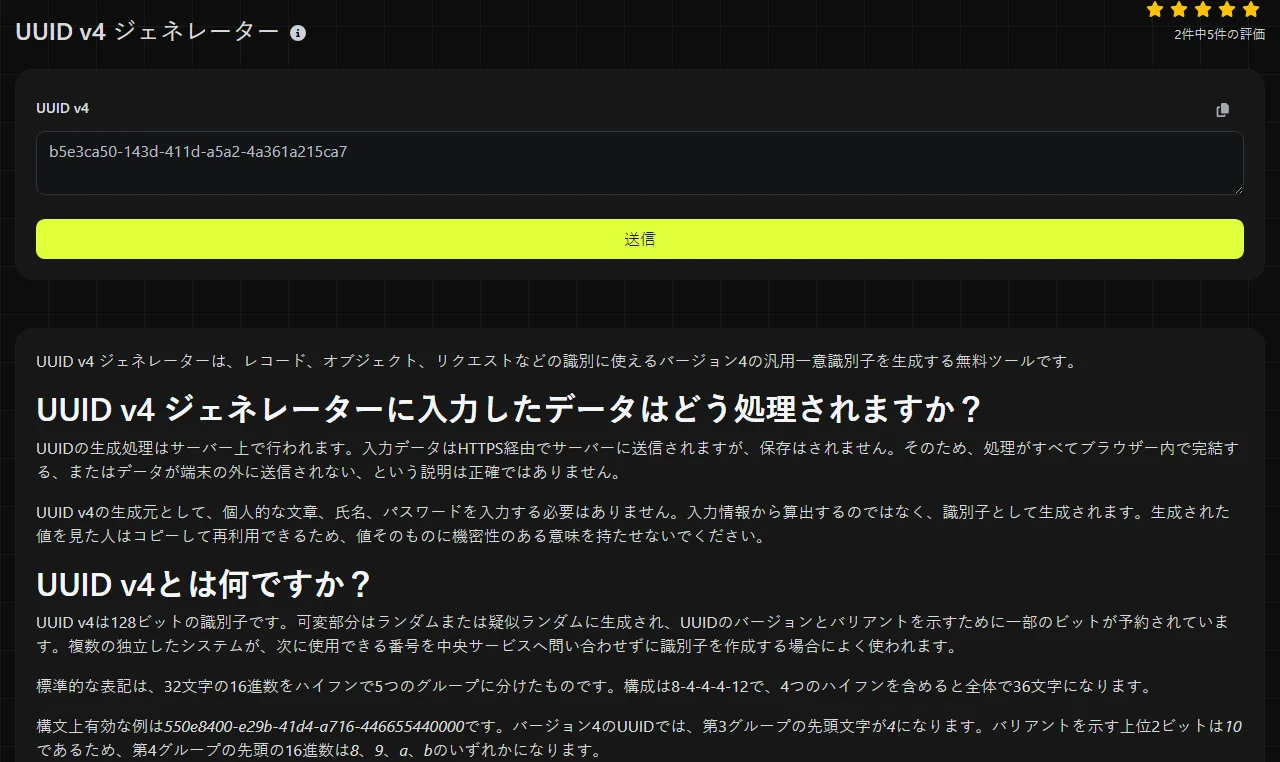
UUID v4 ジェネレーターは、レコード、オブジェクト、リクエストなどの識別に使えるバージョン4の汎用一意識別子を生成する無料ツールです。
UUID v4 ジェネレーターに入力したデータはどう処理されますか?
UUIDの生成処理はサーバー上で行われます。入力データはHTTPS経由でサーバーに送信されますが、保存はされません。そのため、処理がすべてブラウザー内で完結する、またはデータが端末の外に送信されない、という説明は正確ではありません。
UUID v4の生成元として、個人的な文章、氏名、パスワードを入力する必要はありません。入力情報から算出するのではなく、識別子として生成されます。生成された値を見た人はコピーして再利用できるため、値そのものに機密性のある意味を持たせないでください。
UUID v4とは何ですか?
UUID v4は128ビットの識別子です。可変部分はランダムまたは疑似ランダムに生成され、UUIDのバージョンとバリアントを示すために一部のビットが予約されています。複数の独立したシステムが、次に使用できる番号を中央サービスへ問い合わせずに識別子を作成する場合によく使われます。
標準的な表記は、32文字の16進数をハイフンで5つのグループに分けたものです。構成は8-4-4-4-12で、4つのハイフンを含めると全体で36文字になります。
構文上有効な例は550e8400-e29b-41d4-a716-446655440000です。バージョン4のUUIDでは、第3グループの先頭文字が4になります。バリアントを示す上位2ビットは10であるため、第4グループの先頭の16進数は8、9、a、bのいずれかになります。
この値は識別子であり、情報をエンコードしたものではありません。デコードして作成日時、アカウント名、マシンアドレス、連番を復元することはできません。
どのバージョンのUUIDを選べばよいですか?
独立して生成できる、内容を推測できない識別子が必要で、同じ入力から同じ結果を得る必要がない場合は、バージョン4を選びます。各バージョンを簡単にまとめると、v1は時刻とノード情報を使用し、v2はDCE Security形式、v3は名前空間と名前からMD5を使ってUUIDを導出し、v4はランダム、v5はSHA-1を使って導出します。v6は時刻ベースのデータを並べ替え、v7はUnixタイムスタンプとランダムデータを組み合わせ、v8は実験用またはベンダー固有の形式を想定しています。
- ランダムに分散する識別子が適している場合は、レコードID、アップロード参照、APIリクエストID、テスト用フィクスチャにUUID v4を使います。
- 特定の名前空間と名前から常に同じ識別子を生成する必要がある場合は、UUID v5を使います。再現可能なインポート処理や重複排除ルールに適しています。
- レコードの識別子をおおむね作成時刻の順に並べる必要があり、データベースやソフトウェアが対応している場合は、UUID v7を検討します。
- 1つのデータベースで値を作成し、分散生成よりもコンパクトで自然に並ぶキーを重視する場合は、通常の連番整数を使います。
既存システムでは古いバージョンも使われていますが、新しく設計する場合は、すべてのUUIDバージョンを同じものとして扱わず、実際の要件に合わせて選んでください。
UUID v4の実践的な使い方
UUIDを生成したら、結果欄のUUID v4から値を取得します。受け取り側のシステムで別の表現形式が指定されていない限り、完全な標準形式の文字列を保存してください。
- 識別が必要なオブジェクトまたはイベントごとに、新しいUUIDを生成します。
- システム間で受け渡すときは、5つのグループと4つのハイフンをすべて残します。
- データベースにUUID型がある場合は、それを使用します。ない場合は、選んだ表現形式に合うサイズのテキスト型またはバイナリ型フィールドを使います。
- 生成されたUUID v4の重複をデータベースで拒否する必要がある場合は、一意制約を追加します。
一般的な用途には、注文がメインデータベースへ到達する前の識別、複数サービスにまたがるログ項目の関連付け、アップロードしたオブジェクトの命名、インポート用に準備した行への固定IDの割り当てなどがあります。ローカルな連番整数は各データソースで同じ値が使われる可能性がありますが、UUIDなら独立して作成されたデータセット同士を比較的簡単に統合できます。
UUID v4はテキストから識別子を導出しないため、空白、句読点、アクセント付き文字、非ラテン文字を入力として扱う際の問題はありません。このような文字を含む名前を基に識別子を作る必要がある場合は、名前ベースのUUID方式を使い、文字エンコーディングと正規化の規則を厳密に定めてください。そうしないと、見た目が同じテキストでも異なるバイト列になり、別の識別子が生成されることがあります。
同じUUID v4が生成されることはありますか?
はい、理論上は衝突する可能性があります。ただし、適切な乱数源を使って生成していれば、通常のUUID v4の利用で現実的な問題になることはありません。v4 UUIDでは、残りのビットがバージョンとバリアントを示すため、可変部分は122ビットです。そのため、取り得る値の数は極めて膨大です。
したがって、"汎用一意"という表現は数学的な保証ではなく、実用上の説明です。偶然の衝突よりも、誤って値をコピーまたは再利用すること、実装上の不具合、不十分な乱数源による質の低い乱数生成のほうが、現実的な重複リスクになります。重複を許容できないシステムでは、データベースまたはアプリケーションの境界で一意性を必ず適用してください。
また、UUIDはリクエストが正当であることを証明しません。公開されているUUIDだけを認可に使わないでください。アドレスを推測しにくいという理由だけで、オブジェクトが保護されていると考えるのも危険です。UUIDが指す実際のリソースに対して、アクセスチェックを行う必要があります。
よくある質問
UUIDは大文字と小文字を区別しますか?
いいえ。UUID表記内の16進数の英字は通常、大文字と小文字を区別せずに扱われるため、Aとaは同じ値を表します。標準的な表記では小文字が一般的です。文字列を大文字と小文字を区別して比較するシステムでは、比較前に表記を統一すると結果の不一致を防げます。
UUID v4はURLやファイル名に使えますか?
はい。標準形式で使われるのは16進数とハイフンだけで、一般的なURLのパス部分やファイルシステムで使用できます。特定のAPIで必要とされない限り、中括弧は付けないでください。また、URLでUUIDを公開しても、そのリソースが非公開になるわけではありません。
UUIDからハイフンを削除してもよいですか?
受け取り側の形式で32文字の16進数が明示的に求められている場合に限り、削除してください。多くのライブラリやデータベースのUUID型は、ハイフンを含む標準形式を受け付けます。この形式は人がUUIDだと認識しやすく、無関係な16進数の値と混同されにくいという利点もあります。
UUID v4はパスワードやAPIシークレットに使えますか?
いいえ。識別子と秘密情報では目的が異なります。一部のUUID実装では適切な乱数が使われている場合もありますが、UUID形式そのものは、パスワード、セッショントークン、API認証情報に必要な取り扱い、機密性、エントロピーを保証しません。認証情報やトークンは、UUID v4 ジェネレーターではなく、その目的のために設計された仕組みで生成してください。
UUID v4は個人情報保護法上の個人情報に該当しますか?
はい。文字列から氏名を直接読み取れなくても、識別可能な個人を特定できる場合や、その個人と結び付けられる場合は、個人情報に該当することがあります。顧客アカウント、端末、行動記録に関連付けられたUUIDは、利用状況と組織の保存期間およびアクセスに関する規則に従って取り扱ってください。
UUID v4をデータベースの主キーに使えますか?
はい。多くのデータベースはUUIDの主キーを直接サポートしています。ランダムに分散するキーは、連番整数や時刻ベースの識別子に比べて、インデックスへの挿入位置が分散しやすくなります。書き込み量の多いテーブルでは、使用するデータベースの指針を確認してください。一意制約を維持し、インポート、クエリ、アプリケーションコードのすべてで一貫した保存形式を使います。
人気のツール
Digily LinkのIPルックアップツールは、任意のIPアドレスに関する詳細情報を提供します。この無料オンラインサービスを利用して、包括的なIPデータを取得してください。
WhatsAppリンクジェネレーターで無料のWhatsAppリンクを即座に生成します。カスタムメッセージを追加して、ワンクリックでチャットを開始できます。ログインやコーディングは不要です。